
压缩对话的含义
每个模型都有一个上下文窗口,即它一次可以处理的文本量。Anthropic 的使用指南将其称为“Claude 的工作记忆,决定了它一次可以处理和记住多少内容”。包含粘贴文档、工具结果和多次往返的长对话会填满它。
压缩是让对话突破该限制的关键。Claude 用总结替换掉它正在处理的最旧部分,然后继续运行。Anthropic 的描述是:“对于启用了代码执行的用户,Claude 现在会自动管理长对话。当您的对话接近上下文窗口限制时,Claude 会总结之前的消息以无缝继续对话。这意味着您可以进行更长、更自然的对话,且中断更少。”
帮助中心还提到了在压缩过程中你可能看到的状态:在长对话期间,Claude 可能会显示它正在整理思绪,Anthropic 表示这“表明自动上下文管理正在运行”。
哪些被总结,哪些被保留
这里涉及两个不同的概念,区分它们可以解决大部分担忧。
Claude 的工作内容。 之前的消息被总结了,因此在接下来的回合中,Claude 根据总结加上最近的消息进行工作。总结中未保留的细节将不再以完整形式呈现在模型面前。
您的聊天记录。 对话本身并没有被删除。Anthropic 表示:“您的完整聊天记录将被保留,因此即使在总结之后,Claude 也可以引用它。”你仍然可以向上滚动并阅读每一条消息。
因此,在压缩之后,如果 Claude 似乎丢失了对话早期的某个细节,该细节仍然存在于历史记录中。指引 Claude 查看该处,或者再次粘贴相关部分,它就又能在面前看到它了。
自动压缩何时运行
必须开启代码执行
该功能有一个要求:“必须启用代码执行才能进行自动上下文管理。”根据 Anthropic 的文件创建指南,Free、Pro、Max 和 Ultra 计划默认开启代码执行和文件创建功能,而在 Team 和新的 Enterprise 组织中,管理员可以将其关闭。
如果你使用的是个人计划且该功能已关闭,设置位于“Settings > Capabilities”中,开关名为“Code execution and file creation”,或者在更新后的设置布局中称为“Create and edit files”。
接近限制时
当对话“接近上下文窗口限制”时,压缩就会运行。这发生的速度取决于模型。Anthropic 的上下文窗口文章列出,对于付费计划的聊天,最新模型为 1M token,其他一些模型为 500K,而“在这些模型之外,Claude 的上下文窗口大小为 200K”。它还指出,“上下文窗口的一部分始终预留给 Claude 的回复,因此最长的可能对话略小于完整窗口”。
窗口较小的模型在同一个对话中会更早触发压缩。
为什么它似乎在反复发生
当对话再次增长到限制时,它会再次压缩。每一个新回合都会增加文本,而大型添加项会一次性增加很多:长篇粘贴、上传的文件以及连接工具的结果。
Anthropic 列出的腾出空间的方法指向了这些来源:
- 关闭不需要的工具。 “工具和连接器是 token 密集型的,因此管理它们有助于最大化可用上下文窗口并优化您的使用限制。”
- 缩短项目指令。 让它们专注于通用上下文,并“将特定任务的指令保留在聊天本身中”。
- 删除未使用的项目文件。 Anthropic 建议清理你不再积极使用的文件。
- 关闭思考或降低努力程度。 Anthropic 表示,更高的努力程度会消耗更多 token。
压缩过多次的对话实际上是在根据“总结的总结”进行工作。这是开启新对话的一个理由,如下所述。
为什么长对话会消耗更多额度
压缩能让对话持续进行,但它不是免费的。Anthropic 表示:“触发自动上下文管理的长对话会消耗更多使用限额。如果您在长对话中接近使用限额,请尝试开始新对话。”
使用限制和长度限制是分开的。使用指南解释说,“使用限制控制您在所有对话中可以使用 Claude 的总量,而长度限制控制任何单个对话可以达到的长度。”压缩有助于解决后者,但长对话仍然会消耗前者。
当对话仍然过长时
压缩涵盖了大多数长对话,但并非所有情况。Anthropic 指出:“罕见的边缘情况(例如非常大的第一条消息)可能仍会遇到上下文限制。”
达到长度限制时的指导建议是:“如果您达到长度限制,可以开始新对话或使用项目等功能,以更有效地处理大量信息。”
项目处理大型资料的方式不同
项目是 Anthropic 针对大型参考资料的解决方案。“项目使用检索增强生成 (RAG),通过仅将相关内容加载到上下文窗口中,允许 Claude 更有效地处理大量信息。”与其将相同的文档粘贴到聊天中,不如将它们放入项目的知识库中,每次聊天只加载相关内容。关于 Claude 为何遗忘项目知识文件的指南涵盖了当项目文件似乎没有生效时应检查的内容。
将长对话延续到新对话中
开始新聊天并不意味着从零开始。
聊天搜索。 “您可以提示 Claude 搜索之前的对话,以便在新聊天中查找并引用相关信息。”在新聊天中要求 Claude 查找你们讨论过的内容。在项目内部,搜索仅限于该项目;我们在项目中搜索过去聊天的指南解释了其中的界限。
记忆 (Memory)。 如果开启了记忆功能,Anthropic 表示 Claude “在聊天时会将记忆保存为一组独立的主题,而不是在对话结束后进行总结”。你在长对话中确定的一些内容可能已经存在于记忆中了。关于 Claude 新记忆条目的指南涵盖了这些主题的运作方式,而关于 Claude 记忆不工作的指南涵盖了如果它们没有出现时该检查什么。
你撰写的总结。 在离开长对话之前,要求 Claude 总结已确定的决定和待解决的问题,阅读并纠正它,然后将其作为新聊天的第一条消息粘贴进去。
无痕聊天 (Incognito chats) 是个例外:Claude 在搜索之前的对话时不会从中提取信息。我们的无痕聊天指南解释了它们排除了哪些内容。
Claude 聊天与 Claude Code 的压缩方式不同
如果你同时使用两者,同一个词涵盖了两种机制。在 Claude Code 中,压缩是你可以通过 /compact 触发的操作,Anthropic 的上下文窗口指南记录了之后会恢复的内容:诸如项目根目录下的 CLAUDE.md 和自动记忆等文件会“从磁盘重新注入”。
在 Claude 聊天中,帮助中心描述的是自动上下文管理,没有手动运行的命令,也没有重新注入内容的表格。记录的要点如上所述:之前的消息被总结,完整聊天记录被保留,必须开启代码执行,且长对话消耗更多额度。请围绕这些点进行规划,而不是参考 Claude Code 的行为。
人们首先尝试的方法
当压缩似乎卡住时死等。 Anthropic 的帮助中心没有描述“停滞”状态。它对达到长度限制的对话的建议是开始新对话,所以请带上总结。
假设早期消息被删除了。 Anthropic 表示完整聊天记录会被保留。
再次粘贴相同的大型文档。 这会更快填满窗口。请改用项目的知识库。
开启所有连接器。 Anthropic 称工具和连接器是 token 密集型的。
将长对话视为唯一记录。 经过几次压缩后,Claude 是根据早期总结的总结来工作的。
解决方案:保持长对话精简,并带着总结重新开始
第 1 步:在达到限制前腾出空间
关闭聊天不需要的连接器和网页搜索,将参考文档移入项目知识库,并保持项目指令简短。如果你想要自动上下文管理,请检查代码执行是否已开启。
第 2 步:当对话压缩超过一次时,要求提供总结
要求 Claude 列出对话中的决定、约束和待解决的问题。对照历史记录阅读并纠正总结中的任何错误。
第 3 步:在新对话中继续
开始新聊天(如果在项目中,则在项目内开始),粘贴纠正后的总结,并要求 Claude 搜索过去的聊天以获取你需要的任何其他内容。长对话保留在历史记录中以供参考。对于 ChatGPT 中的类似问题,关于 ChatGPT 遗忘对话早期内容的指南涵盖了那里的相同模式。
在 MemoryLake 中设置
压缩能让对话持续,但每次压缩都是由一个非你撰写的总结来判断保留什么。你无法承受丢失风险的决定,放在任何单一对话之外会更安全。
MemoryLake 是一个记忆层,用于将这些决定保存在一个由你维护的地方,供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你用自己的语言亲自编写条目。你的 Claude 聊天、聊天记录、Claude 记忆、项目或任何供应商的存储空间都不会被读取、写入或删除。自动上下文管理将继续按照 Anthropic 描述的方式工作。
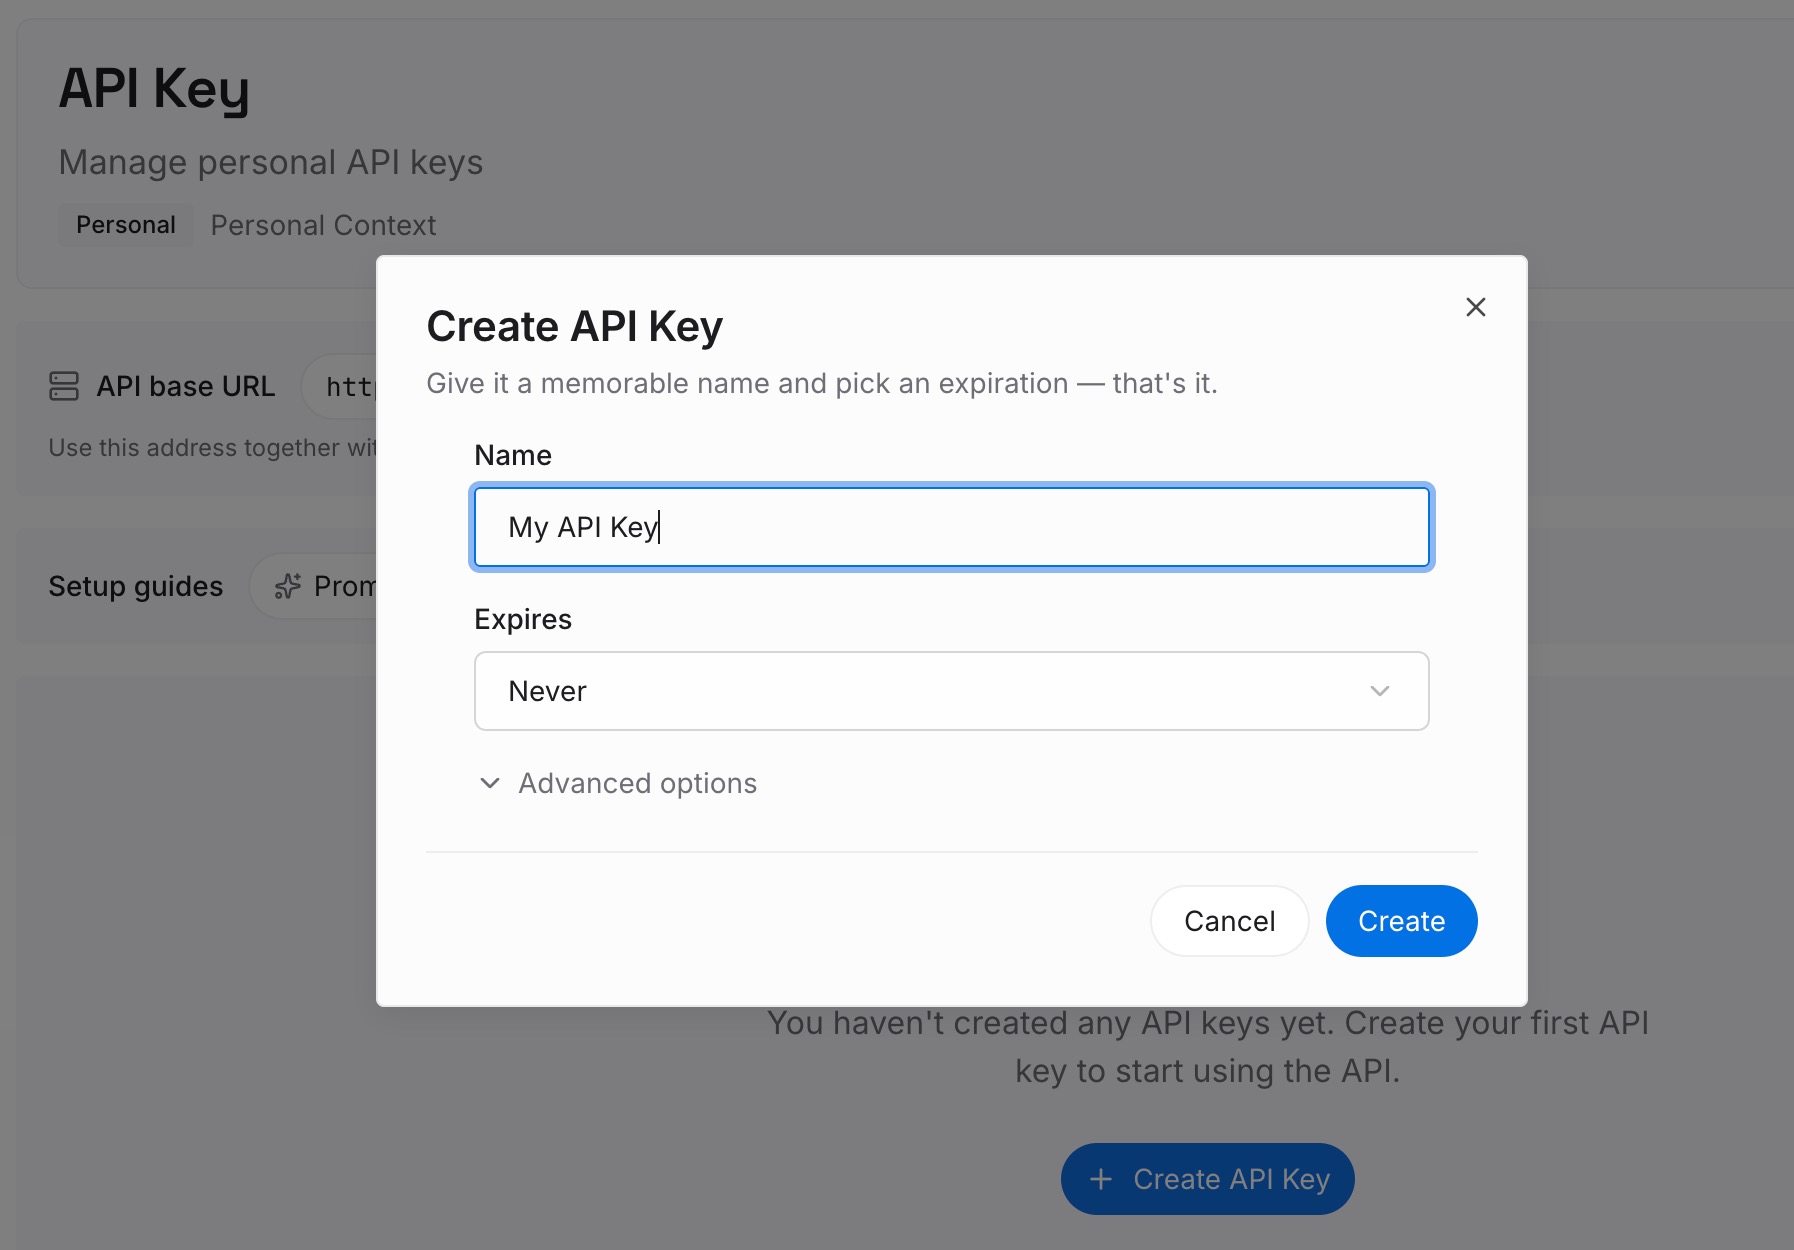
第 1 步:创建 API 密钥
登录并从控制面板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的 Claude 账号是分开的。
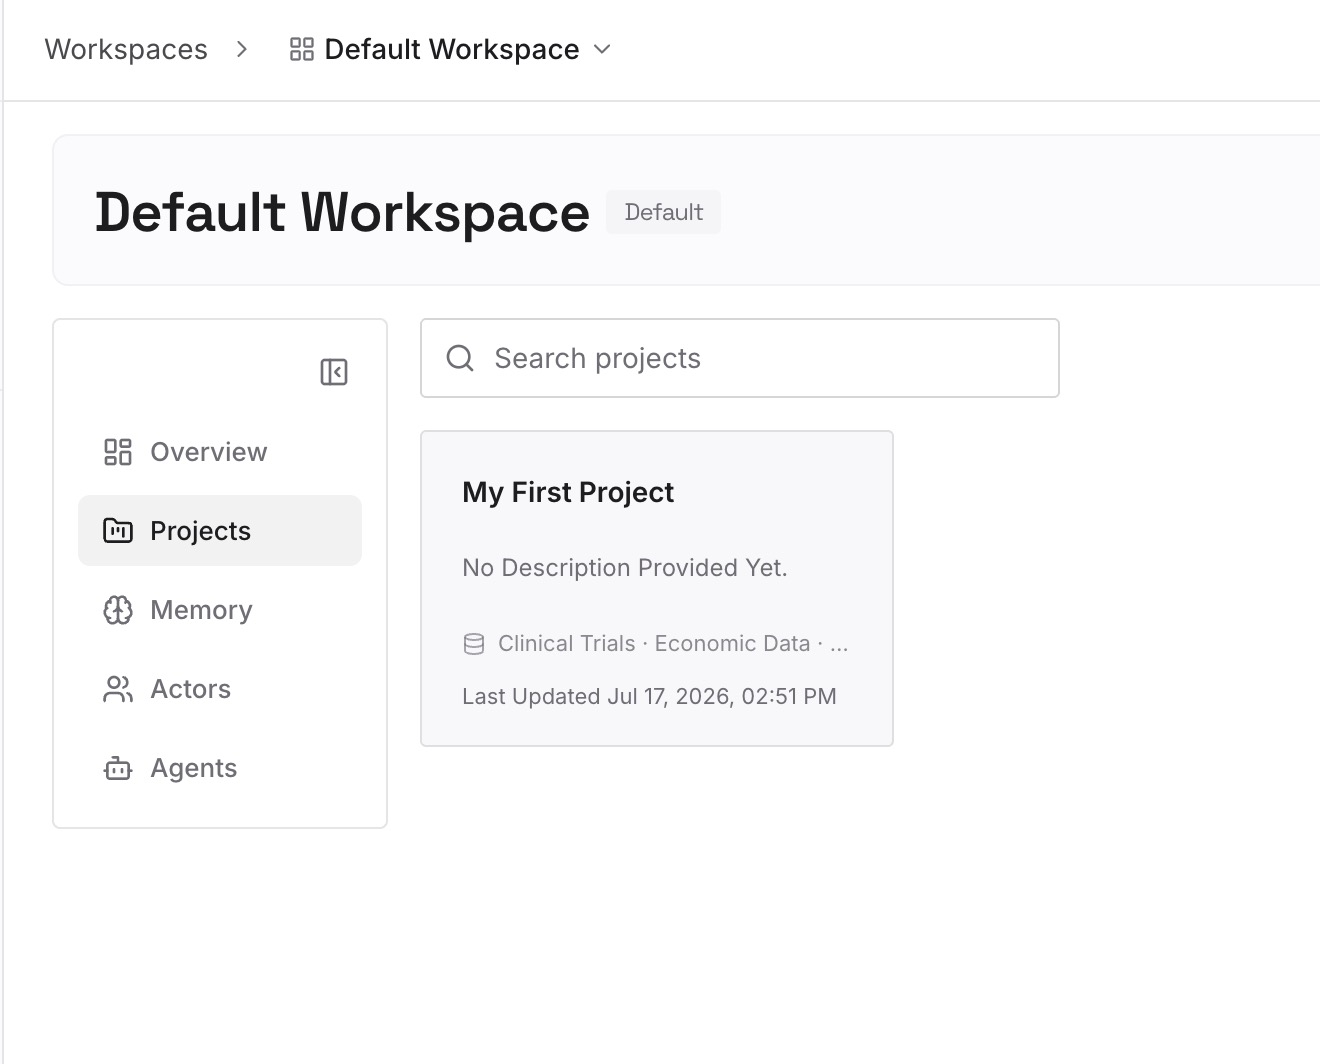
第 2 步:上传你的第一批记忆
从解决方案第 2 步中纠正后的总结开始:决定、约束和待解决的问题。每个条目一个要点,并注明日期。
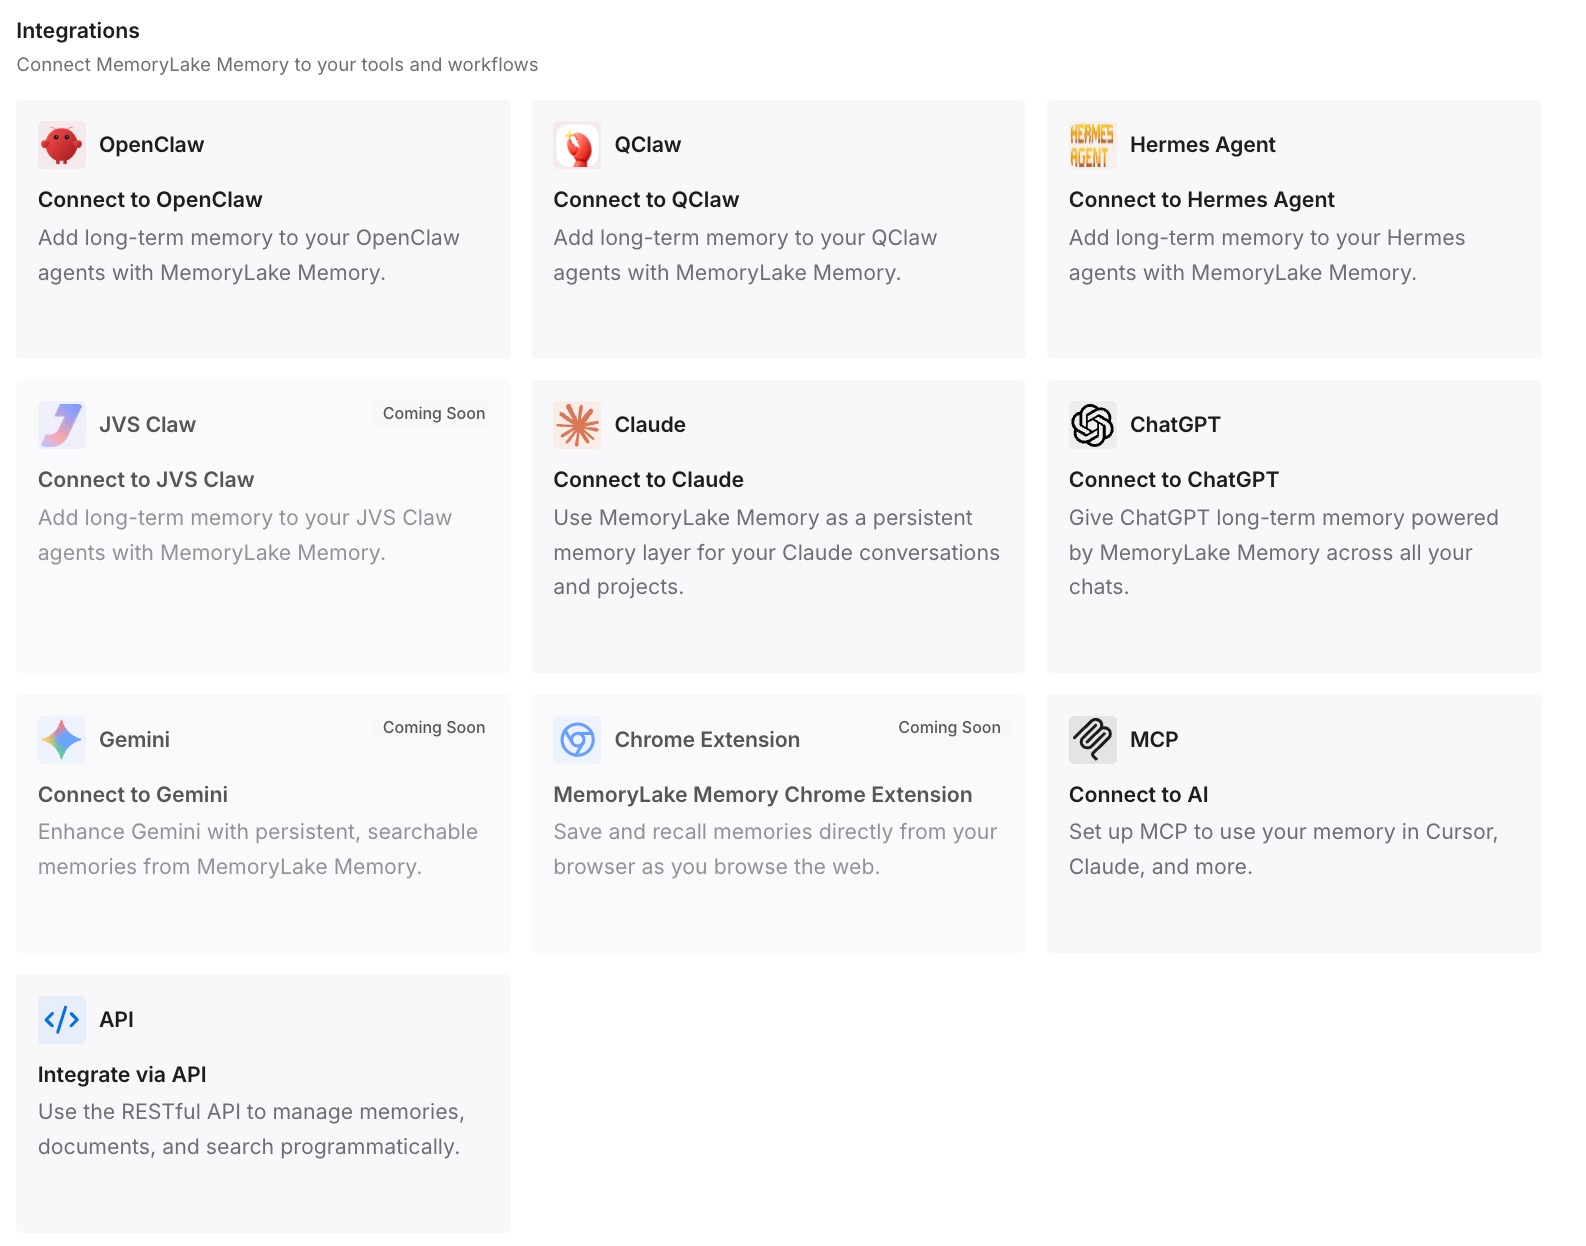
第 3 步:连接你的 AI 和代理
连接 Claude Code 和你使用的任何其他助手。相同的条目在新聊天、新项目或不同的工具中均可使用。
这在实践中改变了什么
第一个区别是聊天变得更短。当决定被记录下来后,你不需要为了保留它们而维持一个长对话。
第二个区别是压缩后的意外更少。你记录的事实不依赖于总结保留了什么。
第三个区别是减少了因长度产生的使用消耗。Anthropic 自己对接近使用限额的长对话的建议是开始新对话,而简短的总结让这变得很容易。
长 Claude 对话的最佳实践
保持代码执行开启。 自动上下文管理需要它。
留意填满窗口的内容。 工具、连接器和大型粘贴会迅速累积。
使用项目处理参考资料。 RAG 仅加载相关内容。
在反复压缩后重新开始。 带上你检查过的总结。
记住历史记录仍然存在。 向上滚动或指引 Claude 查看它。
注意你的使用额度。 触发压缩的长对话会消耗更多使用限额。
结论
当 Claude 压缩对话时,它会总结之前的消息,以便聊天可以突破上下文窗口继续进行。Anthropic 表示你的完整聊天记录会被保留,因此你的消息留在历史记录中,但 Claude 在随后的回合中根据总结进行工作。该功能需要代码执行,在接近限制时运行,并在长对话中消耗更多使用限额。
对话仍然可能过长,例如第一条消息非常大。当这种情况发生,或者当对话压缩超过一次时,请带上你检查过的总结开始新对话,使用项目处理大型资料,并将重要的决定保存在聊天之外的某个地方。