
11 月 2 日发生了什么变化
在引入线程之前,每个 Messages API 请求都必须携带整个对话。公告描述了这种成本:“一个编码智能体在一个会话中可能会发出数百个请求,而每个请求都会重新发送之前的所有消息和工具结果。”
使用线程后,你只需在 Messages API 请求中添加一个参数 thread。文档将该模式分为三个步骤:
- 创建 (Create)。 你的第一个请求携带完整的对话、
system和tools,外加一个类型为create的thread字段。“API 会在响应id下存储对话,包括 Claude 的回复。” - 继续 (Continue)。 “仅发送自上一次响应以来的消息”。你还需要传递上一次响应的
id,并且无需包含system和tools,因为线程会保留创建请求中的值。 - 重放 (Replay)。 当线程无法继续时,你在新的创建请求中再次发送完整的对话。
线程可在原生 Claude Platform、AWS 上的 Claude Platform、Microsoft Foundry 中的 Claude 以及 Google Cloud 上的 Claude Models(Anthropic 托管)中使用。Anthropic 表示“适用标准的 Claude Token 费率和现有的速率限制”。
服务器保留什么,保留多久
文档本身的总结是:“Message Thread 在服务器上短时间保留对话。”
最后一次请求后五分钟。 “线程是尽力而为的。它在最后一次请求 5 分钟后过期,API 在最后一次使用后不超过 1 小时内将其删除。API 存储的每个响应都会重新开始这 5 分钟的计时。”
在内存中,不在磁盘上。 公告称:“在轮次之间,我们将每个线程保存在内存中,并在那里进行加密,不会写入磁盘。”数据保留部分补充说,API “绝不会将其写入持久存储”。
无法查看内部。 限制列表非常直接:“没有用于列出、读取或删除线程的 API。”
绑定到调用者。 在继续请求失败的原因中,文档列出了来自“不同组织或工作区”的请求,以及来自“与创建线程的用户或服务账户不同的用户或服务账户”的请求。
因此,服务器仅为单一调用者保留一个对话,仅限几分钟的空闲时间,且形式仅限追加。这对于快速的智能体循环很有用,但它不是你可以明天再回来查看的记录。
为什么线程不是记忆
Anthropic 在页面上最重要的指令中回答了这个问题:“你的应用程序仍然是对话的单一事实来源。请保留每条消息的副本,并从头构建重放路径。”
它还告诉你为什么不能跳过副本:“无论是创建请求还是继续请求,没有任何响应会说明 API 是否存储了该轮次。你只有在下一次继续请求时才会发现。”线程可能会因为你无法控制的原因消失。文档列举了几个原因,包括“线程已过期”、API 处理了该轮次但未存储,以及后备模型编写了上一次响应。
将其与 Anthropic 描述的用于保留信息的工具进行对比。其记忆工具被记录为一种“通过在你的应用程序中实现记忆工具的文件操作,让 Claude 跨对话存储和检索信息”的方式。其数据保留说明称之为“由你控制数据保留的客户端记忆存储”。持久存在的东西在你的那一侧,在你运行的存储中。
这个名称也可能在另一种方式上误导你。文档包含一条注释:“Message Threads 与 Claude Managed Agents 中的 Session Threads 不同。”Session Threads 属于 Managed Agents 会话,Anthropic 将其描述为“有状态资源;转录内容会一直保留,直到你删除它们”。同样的词,不同的生命周期。
我们关于为什么长上下文窗口不是记忆的指南涵盖了模型在单个请求中可以容纳的内容与它在请求之间保留的内容之间的更广泛区别。
为什么压缩必须启动新线程
长时间的智能体会话最终需要压缩:用摘要替换旧的轮次,以便对话能够容纳。线程改变了你执行此操作的方式。
“线程是只增的,因此你不能用摘要替换其早期的轮次。要压缩对话,请从摘要开始一个新线程。在你的代码中编写摘要,并在新的创建请求中将其作为普通消息发送,同时包含 system 和 tools。”
服务器端选项也不可用。“线程不支持按需压缩。”包含 thread 并请求压缩的请求将返回 400 错误。上下文编辑也处于同样的情况:线程不支持它,只有一个关于 thinking-block 设置的例外。
在实践中,线程上的长会话看起来像一条链。一个线程运行到对话需要压缩为止,你的代码编写摘要,然后从该摘要开始一个新线程。每次,旧线程都会在几分钟内过期。传递下去的是你放入摘要的内容,以及你自己的消息副本。
同样的规则也适用于编辑。“要编辑或分支之前的消息,请通过创建请求启动一个新线程。”更改 system 或 tools 也是一个新线程,因为继续请求会忽略它们。
我们关于传送压缩后的 Claude Code 会话的指南展示了对话压缩后,摘要会携带和不会携带哪些内容。
线程还不支持什么
文档列出了不与线程结合使用的功能。其中一些对智能体构建者很重要:
- Prompt Caching 不是自动的。 “线程不会为你缓存提示词。”你仍然需要放置缓存断点,并且顶层的
cache_control会要求在每一轮进行缓存。 - 批量处理 (Batches) 和 Token 计数。 带有
thread的批量项目会失败,带有thread的 Token 计数请求会返回 400 错误。Anthropic 建议改为计算完整对话的 Token。 - 某些组织。 启用了 HIPAA 就绪性或开启了推理钩子 (Inference hooks) 的组织无法使用线程。
当请求使用了线程不支持的功能时,API 会返回 400 错误,代码为 thread_unsupported_request,文档建议:“如果你收到一个无法识别的值,请发送不带 thread 的完整对话。”
数据保留与零数据保留 (ZDR)
对于有数据保留要求的团队,功能元数据是明确的:“Message Threads 不符合 ZDR 资格。使用此功能不会影响你使用其他符合 ZDR 资格的功能。”
完整说明如下:“线程的内容(对话、系统提示词和工具)保存在内存中,使用服务器管理的密钥加密,绝不写入持久存储,并在线程最后一次使用后不超过 1 小时内删除。”
如果你的组织依赖零数据保留,请在开启线程之前咨询该政策的所有者。SDK 可以回退到非线程请求,文档在其恢复部分涵盖了这一点。
如果你使用 Claude Code
公告中用一行提到了 Claude Code:“对于大多数 Claude Code 用户,Message Threads 默认开启”,随后给出了长请求的延迟数据。
这改变了请求的传输方式。但它不会改变你的 Claude Code 历史记录的存放位置。Claude Code 的文档仍然表示:“Claude Code 将会话存储在 ~/.claude/projects/<encoded-cwd>/*.jsonl 下。”这些本地转录内容是 /resume 读取的内容,而自动记忆保留在磁盘上的独立文件夹中。我们查阅的 Claude Code 文档页面没有描述 Message Threads 的设置。
Anthropic 没有描述 Claude Code 如何处理在你离开时过期的线程。在 API 上,过期后的记录路径是重放:下一个请求再次发送完整对话并启动一个新线程。我们关于在 Claude Code 会话之间共享上下文的指南涵盖了跨会话持久存在的部分。
人们首先会尝试的操作
将线程 ID 视为对话 ID。 线程在最后一次请求几分钟后就会过期。请存储你自己的对话 ID 和消息。
丢弃客户端副本。 文档表示没有任何响应会告诉你某轮对话是否已存储。没有副本,你就无法重放。
在线程上调用压缩。 这会返回 400 错误。请在你的代码中进行压缩,并从摘要开始一个新线程。
期望线程能缓存提示词。 缓存仍然需要你设置断点。
假设 ZDR 设置涵盖了线程。 线程不符合 ZDR 资格。
寻找回读线程的方法。 用 Anthropic 的原话来说,没有用于列出、读取或删除线程的 API。
解决方案:在你的侧保留记录
第 1 步:在发送前存储每条消息
在你控制的存储中保留一份包含 system 和 tools 的对话副本。使用它在 404 错误时进行重放,并在线程过期后进行恢复。Anthropic 指出“SDK 线程助手在助手对象存在期间将此副本保留在内存中,不保存在其他任何地方”,因此如果你的进程可能重启,请将副本写入持久化的地方。
第 2 步:压缩到新线程中
当对话变长时,在你的代码中编写摘要,通过包含该摘要的创建请求启动一个新线程,并在你自己的存储中保留完整历史记录。在需要摘要之前,决定摘要必须保留哪些内容。
第 3 步:将持久事实保留在对话之外
关于用户或项目的决定、约定和事实不应依赖于任何单个对话的存续。将它们放在你的智能体可以在每个新线程开始时加载的地方,例如由你的存储支持的记忆工具或存储库中的文件。在 Claude Code 中,这一角色由 CLAUDE.md 和自动记忆承担;我们关于 Claude Code 自动记忆的指南解释了在每个会话开始时加载的内容。
在 MemoryLake 中设置
线程使当前轮次更快。但智能体跨会话、压缩和工具所需的事实仍然需要一个不会在五分钟沉寂后过期的归宿。
MemoryLake 是一个记忆层,用于将这些事实保存在你维护的一个地方,供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你用自己的语言亲自编写条目。不会从你的 Message Threads、API 对话、Claude Code 会话、记忆工具文件或任何供应商的存储中读取、写入或删除任何内容。Message Threads 继续按照 Anthropic 描述的方式工作。
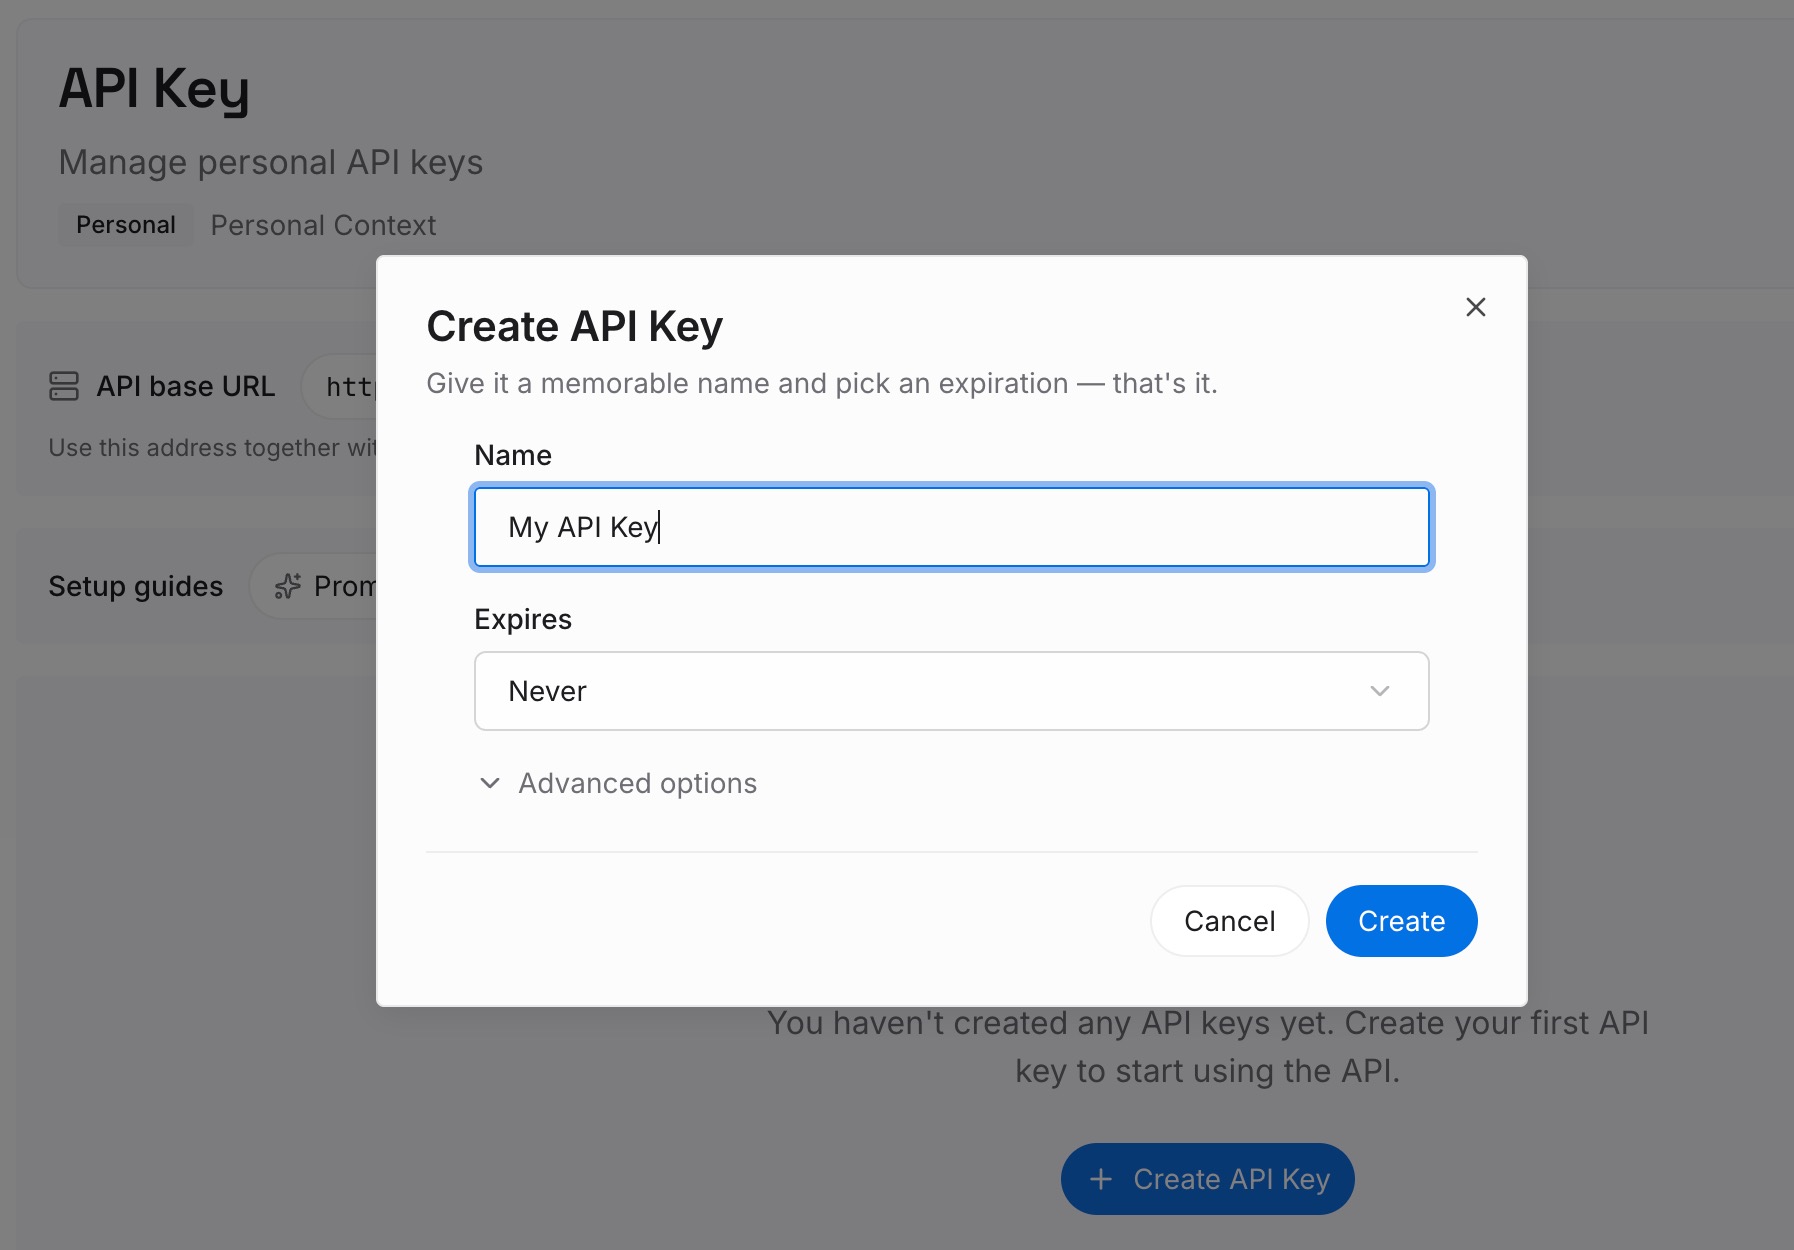
第 1 步:创建 API 密钥
登录并从仪表板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的 Claude Platform 密钥分开。
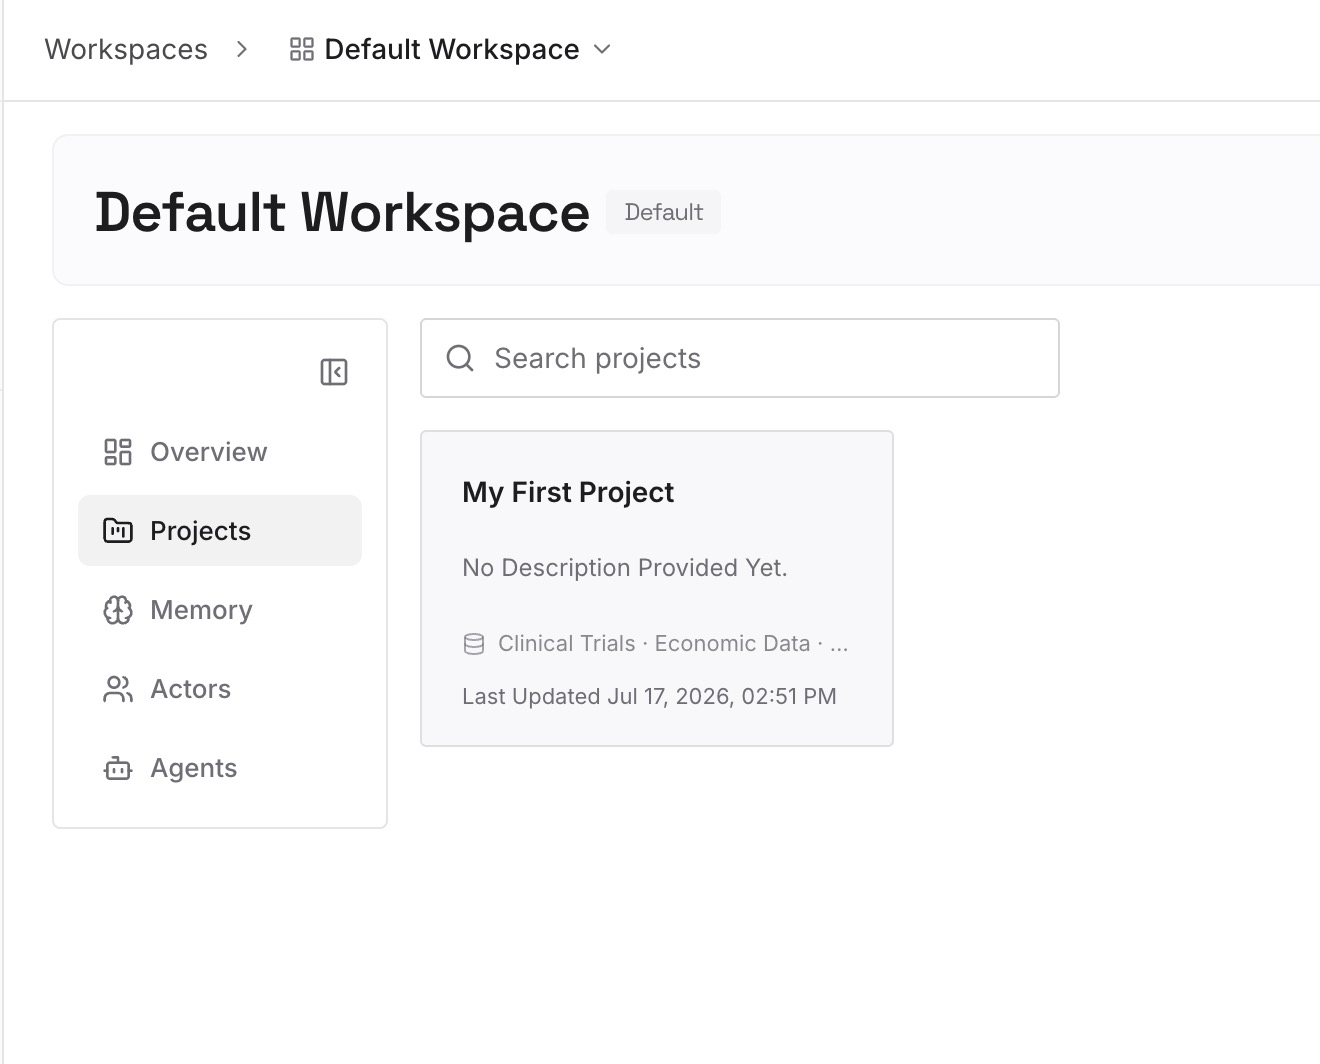
第 2 步:上传你的第一批记忆
从每个新线程在第一轮就应该知道的内容开始:项目决策、约束和约定。每个条目一个要点,并注明日期。
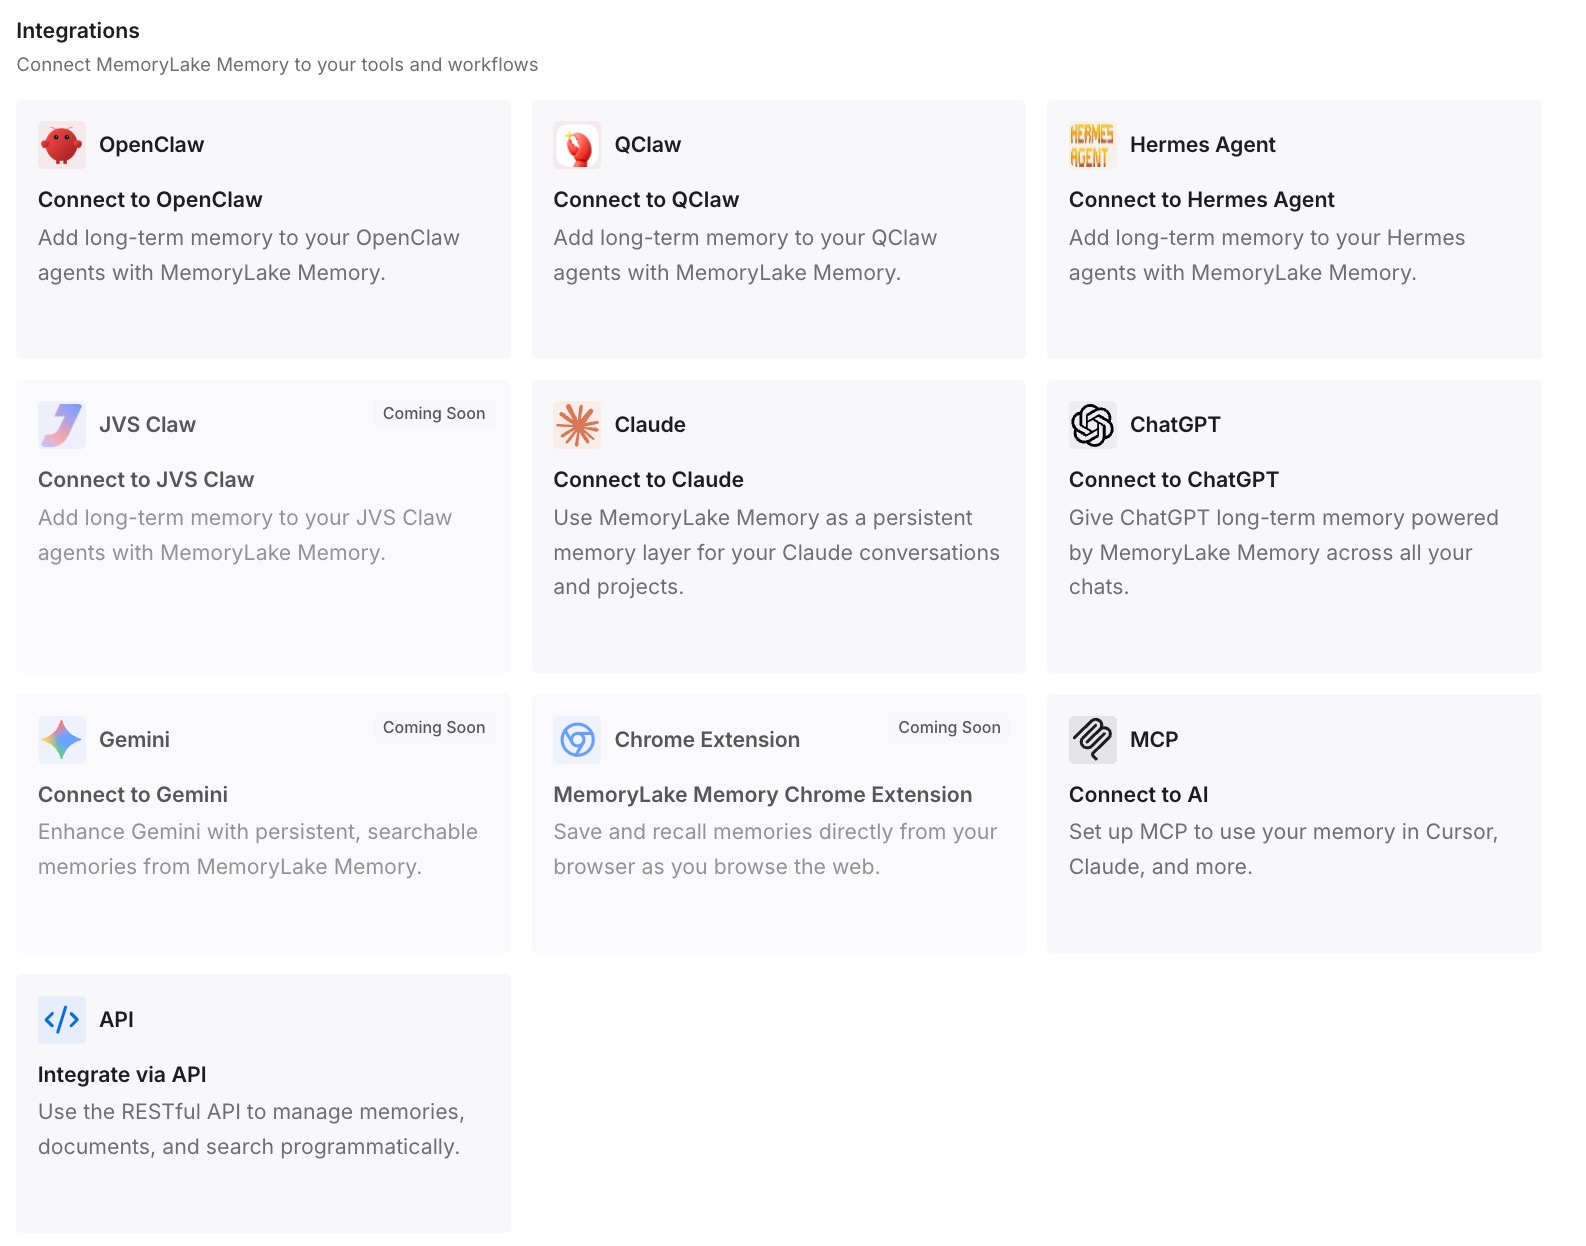
第 3 步:连接你的 AI 和智能体
连接 Claude Code 和你使用的任何其他助手。无论是在线程开始时、压缩后还是在不同的工具中,相同的条目都可用。
这在实践中改变了什么
第一个区别是角色更清晰。线程处理活跃循环的速度,你的消息存储是记录,而长期存在的事实位于它们自己的层中。
第二个区别是更安全的压缩。由于每次压缩都会启动一个新线程,重要事实不再取决于摘要写得有多好。
第三个区别是减少了跨工具的重复解释。如果同一个项目在 Claude Code 和 Codex 中运行,我们关于同时使用 Claude Code 和 Codex 的指南涵盖了如何让两者在相同的上下文下工作。
Message Threads 最佳实践
将线程视为短期缓存。 它在最后一次请求五分钟后过期。
优先构建重放路径。 预见 404 错误并从你的副本重新发送。
为整个线程使用相同的密钥和工作区。 不同的调用者无法继续该线程。
在代码中进行压缩。 从摘要开始一个新线程。
自行设置缓存断点。 线程不会为你进行缓存。
检查保留要求。 线程不符合 ZDR 资格。
将持久事实保留在外部。 在每个线程开始时加载它们。
结论
Message Threads 让智能体在每一轮中仅发送新增内容。Anthropic 将对话加密保存在内存中,在最后一次请求后保留五分钟,并在一个小时内删除。没有用于回读线程的 API,文档要求你保留每条消息的副本。
这使得线程成为单个活跃会话的加速功能,而非记忆。压缩意味着编写摘要并启动新线程,因此传递下去的是你保留的内容:你的消息存储、你的摘要,以及你存储在比任何单一对话都持久的地方的事实。