
为什么相同的指令在长会话中表现不同
首先来看每一层的作用。
工作区知识“最适合用于应在多个项目之间保持一致的规则和约定”。定义一次意味着你“可以避免在每个项目的知识字段中重复相同的指令”。只有工作区所有者和管理员才能管理它,这使其成为安全边界(如编码标准、测试要求、架构规则)的天然归宿。
项目知识可由任何有权编辑该项目的人编辑,并保存该应用特有的内容:其用途、Schema、领域术语、集成等。
两者都是每条消息的背景上下文。Lovable 在“生成编辑之前,会读取你的项目知识、工作区知识和项目代码,以了解你的项目是如何工作的”,以及来自连接服务的集成知识和代码库中的指令文件。
现在来看看限制。每一层“最多支持 10,000 个字符”。每个工作区只有唯一一个工作区知识——“你无法为同一工作区内的部分项目定义不同的工作区级指令”。当这两层发生冲突时,解决方式在文档中是用了一句值得逐字阅读的委婉措辞:Lovable “被鼓励优先考虑项目知识中定义的指令,因为它们专门适用于当前项目。”
“被鼓励”,而不是“保证”。这种措辞异常诚实,它告诉了你一些有用的信息:这里的冲突解决是向模型表达的一种偏好,而不是由加载器强制执行的优先级规则。这意味着处理冲突的可靠方法是根本不产生冲突。
将字符限制、单一工作区层级、冲突解决的软性特征以及长会话警告结合在一起,你会得到一个清晰的指令:知识库适用于必须作为背景、保持简短且不重叠的内容。其他所有内容都需要不同的载体。这与长上下文窗口无法很好地替代结构化记忆的道理相同——容量并不是真正制约你的瓶颈。
人们尝试的其他方法
将两个字段都填满到字符限制。 这是最常见的方法,但它直接违背了长会话警告。更多的背景文本并不意味着更高的遵循度。
“为了安全起见”在两层中放入相同的规则。 这会造成文档警告的冲突情况,并以偏好而非规则来解决它。文档给出的建议恰恰相反:“将共享规则保留在工作区知识中,将项目特定的细节保留在项目知识中。”
将工作区知识用于部分项目。 一个工作区只有一个工作区知识,文档没有描述将其范围限制在工作区内某些项目的方法。一个只适用于你 12 个项目中的 3 个的规则,如果写在工作区级别,就会适用于所有 12 个项目。
将知识库视为任务指令的存放处。 文档对这两者进行了清晰的区分:“知识始终作为 Lovable 的背景上下文包含在内。当请求与技能的描述匹配时,技能会按需加载。”其指导原则是“将知识用于适用于每条消息的规则,将技能用于仅对特定类型任务重要的指令。”
假设长对话的表现与短对话相同。 事实并非如此,文档中已明确指出。解决办法不是提供更长的知识字段。
当智能体偏离轨道时,在聊天中重复规则。 这只对单条消息有效,且无法让你吸取教训。如果一个规则在两小时后不再被遵循,说明该规则放错了载体。
解决方法:按规则适用的频率排序,然后按哪个载体能在长会话中存活排序
三个载体,三项工作。排序规则不是重要性,而是相关频率,然后是持久性。
步骤 1:按适用频率拆分每条规则
将当前知识字段中的所有内容拿出来,将每一行放入三个堆中的一个。
适用于每个项目中的每条消息:编码标准、测试要求、架构约束。这是工作区知识,它应该很短——一页纸,而不是一万个字符。
仅适用于此项目中的每条消息:应用程序的作用、Schema 形状、领域词汇、存在哪些集成。这是项目知识。
仅在出现特定类型的任务时适用:如何添加迁移、发布清单、如何连接新的连接器。这是一项技能。文档中记录的测试标准是该指令“是否在每条消息上都相关”——如果不是,它就是一项技能。
大多数团队会发现第三堆是最大的,而且其中大部分以前都堆在知识字段中,挤占了真正每次都适用的规则。将其移出是这里能做出的最大改进,这种整理方式与将项目文档转化为智能体真正可以使用的 AI 记忆(而不是一堵文字墙)是相同的道理。
步骤 2:将长会话中必须保持有效的任何内容移入代码库
现在,仔细检查这两个知识字段中剩下的内容,并对每一行提出一个更难的问题:在会话的第三个小时,这还需要保持有效吗?
大多数不需要。在长对话后期被不一致地应用的词汇注释只会让你多花时间重命名。但有些确实需要。防止数据丢失的约束、安全要求、关于绝对不能提交什么的规则——在这些方面,不一致的遵循代价是高昂的。
这些内容属于根目录下的 AGENTS.md,常见问题解答中将其描述为“无论会话长度如何,始终会被 Lovable 智能体读取”。文档还指出,诸如 AGENTS.md 或 CLAUDE.md 之类的指令文件“也可以为 Lovable 智能体提供指导”,并将代码库指令文件列为在每条消息上读取的上下文源之一。
This is not about abandoning the knowledge fields. It is about recognising that one carrier carries a documented caveat and another carries a documented guarantee, and putting your few non-negotiable rules in the one with the guarantee.
步骤 3:消除所有重叠,然后测试衔接处
整理好这些堆后,并排阅读这三个载体,并删除所有重复内容。如果一条规则存在于工作区知识中,它就不应该同时存在于项目知识中。如果它在 AGENTS.md 中,它也不应该存在于这两个字段中的任何一个。
这一步使得软性冲突解决变得无关紧要。如果项目知识中没有任何内容与工作区层冲突,你就不需要知道项目知识是否能可靠地胜出。
然后刻意测试衔接处。启动一个项目,请求一些受工作区规则约束的内容,并检查输出。请求一些受项目规则约束的内容,并检查。然后运行一个真正很长的会话——一个小时的实际工作——并重新检查你移入 AGENTS.md 的规则。该警告专门针对长对话,因此两分钟的测试无法告诉你任何信息。
来自同一页面的一个实用提示:如果你在对话中途更新了工作区知识,“Lovable 将在后续消息中使用更新后的指令”。你无需重新启动即可修复规则,这使得这种测试的成本非常低。
在 MemoryLake 中进行设置
无论你使用哪种工具进行构建,这种整理都会产生一小组适用的决策——架构约束、领域词汇、每个标准背后的原因。MemoryLake 是保存这一组决策的地方,这样它就不会局限于单个工作区的字符预算。
你用自己的话亲自编写这些条目。不会从 Lovable 工作区知识、项目知识或任何供应商的存储中读取、写入或删除任何内容。
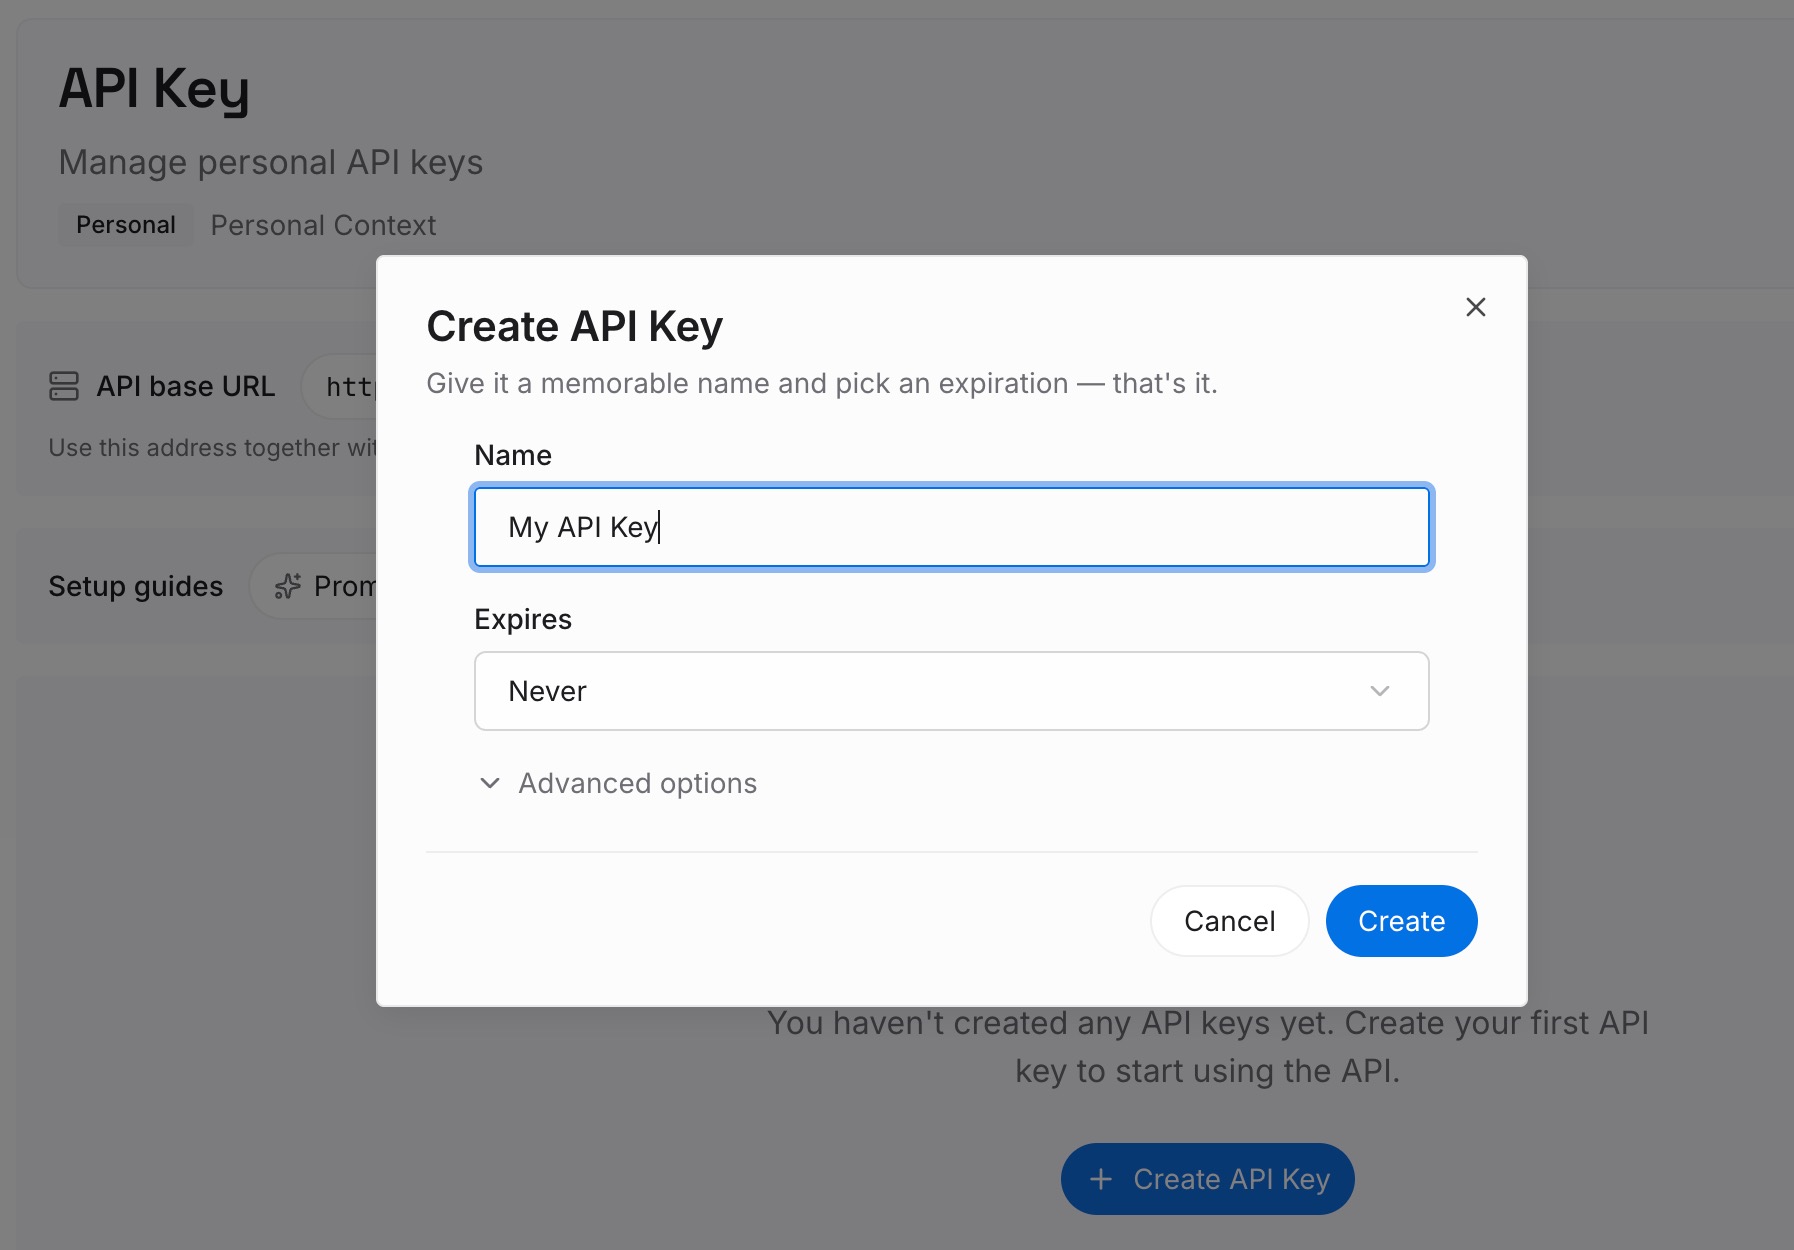
步骤 1:创建 API 密钥
登录并在控制面板中生成一个密钥。该密钥可以让智能体在 Lovable 以及你团队使用的任何其他工具中读取你编写的条目。
步骤 2:上传你的第一批记忆
添加决策及其原因,每个条目包含一个事实。知识字段保存指令;条目保存其存在的原因。这种拆分很重要,因为一万个字符的预算会迫使你放弃推理过程,而推理过程正是让规则在一年后仍可审查的关键。
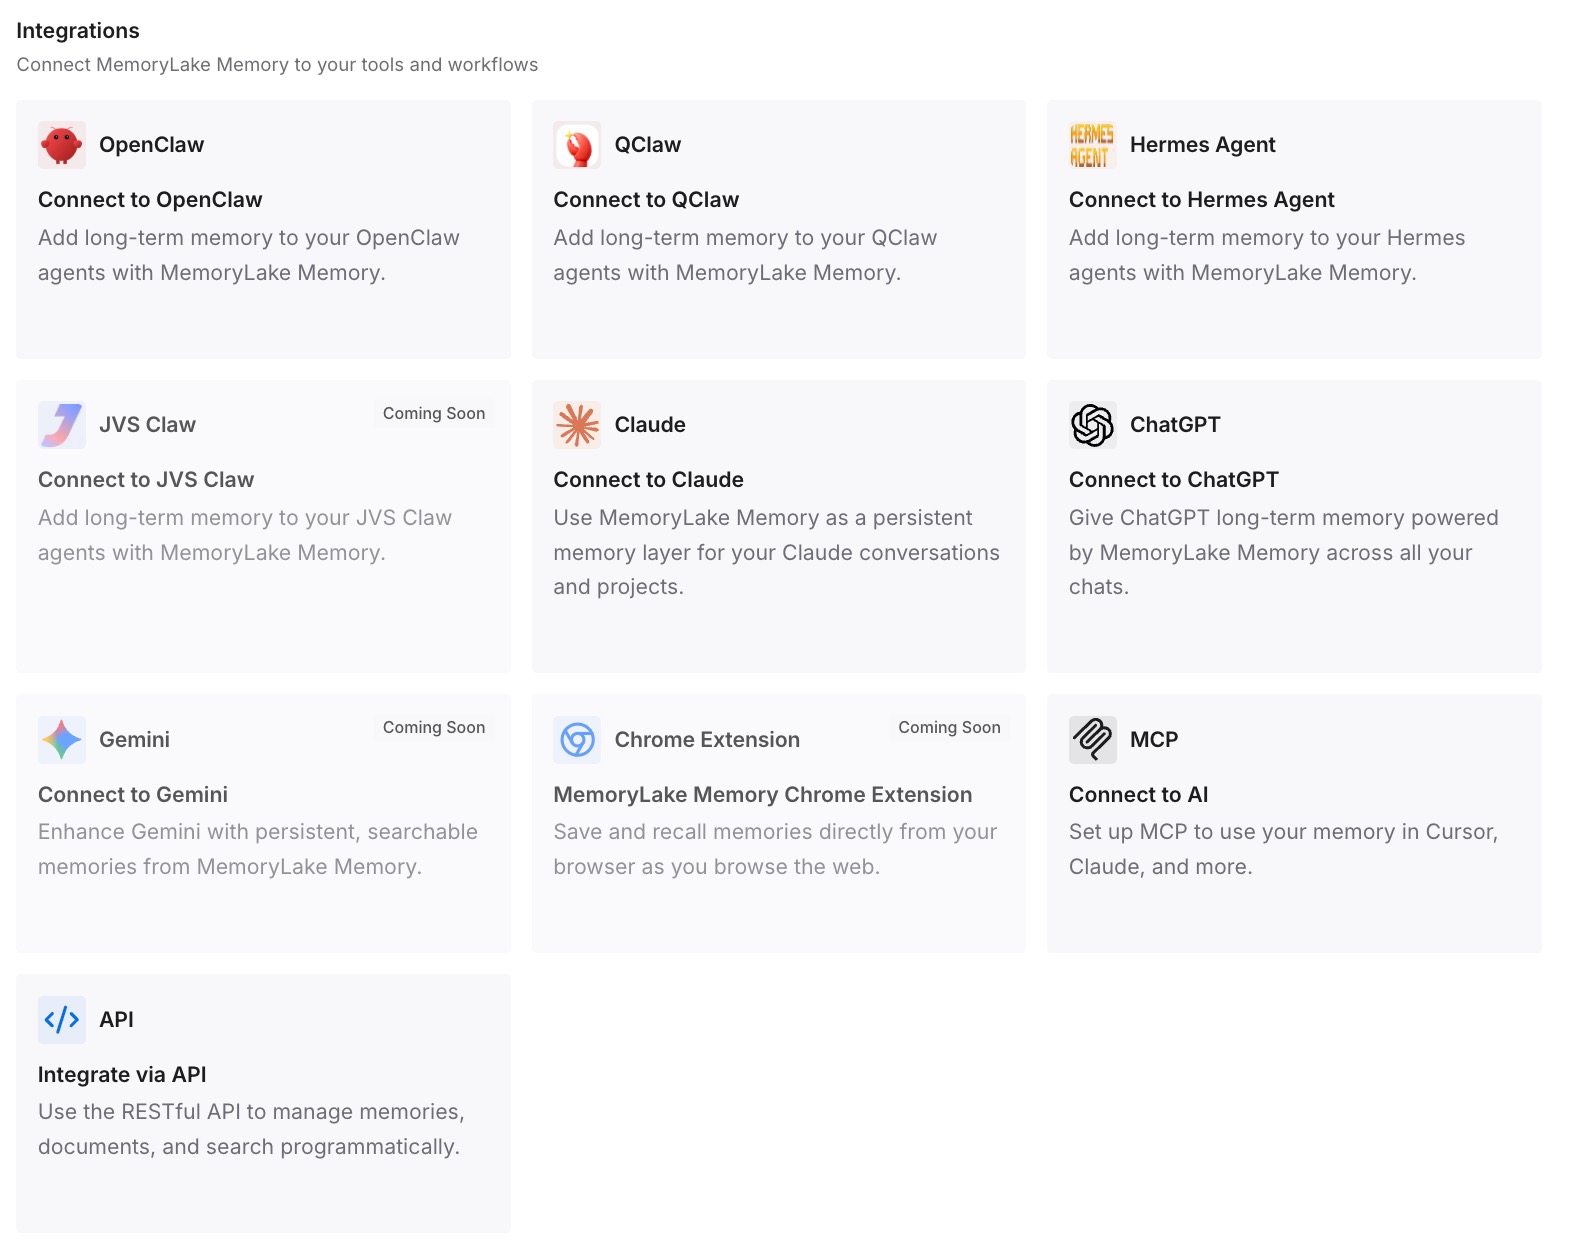
步骤 3:连接你的 AI 和智能体
将你的智能体指向该工作区。这样,在不同工具中工作的团队成员也可以使用相同的既定决策,当工作区管理员是唯一可以编辑工作区知识的人时,这正是你所需要的。
这在实践中带来了什么改变
第一个改变是你的知识字段变短了,而“短”正是关键所在。长会话警告与大量上下文有关,因此精简的背景层是直接的解决办法,而不是权宜之计。
第二个改变是权限结构开始为你提供便利。只有所有者和管理员可以编辑工作区知识,这对于安全边界是正确的,但对于迭代是错误的。当“每条消息-每个项目”这一堆内容真正变小时,管理员瓶颈就不再是瓶颈,因为该层在设计上很少发生变化。
第三个改变是不可妥协的规则获得了一个具有文档记录保证的载体。相比于寄希望于背景指令保持有效,这是一个有意义的升级,而且只需要在代码库中添加一个文件。
一个月后还会显现出第四个效果。一旦技能保存了特定于任务的指令,它们就可以被单独审查——你可以只阅读关于迁移的指令,而无需阅读其他所有内容。一个一万字符的知识字段是没人会去审查的,这就是陈旧规则得以存活的原因。同样的动态解释了为什么团队真正能够维护的知识胜过没人阅读的庞大堆砌,以及为什么明确决定知识何时适用的触发器是值得的。
同样值得了解的是,这里哪些内容不属于讨论范围。聊天连接器从连接的工具中带来实时上下文,自定义连接器携带它们自己的知识文件,这两者都是额外的上下文源,而不是这两个字段的替代品。添加更多源并不能解决关于拥有大量上下文的长会话警告。
分层知识的最佳实践
将字符限制视为不应接近的上限。 每个字段一万个字符是最大值,而不是目标。一个能在一屏内显示完整的工作区层,比填满输入框的层能更可靠地被遵循。
每条规则只有一个归宿,通过共同阅读所有三个载体来强制执行。 重复会将清晰的指令变成通过偏好解决的冲突。
仅在工作区级规则适用于每个项目时,才将其放在工作区级别。 一个工作区只有一个工作区知识,文档没有描述其之下的范围限制机制。适用于三个项目的规则应该属于这三个项目。
将 AGENTS.md 保留给那些不一致遵循代价高昂的规则。 它是具有文档记录的会话长度保证的载体,正因为它简短,它才能保持有用。
将频率作为排序标准,而不是重要性。 重要但偶尔出现的内容属于技能。因为重要而将其放入知识库,是知识字段被填满的原因。
在长会话后进行测试,而不是在短会话后。 文档记录的警告专门针对长对话。快速检查无法证实任何事情。
将原因写在字段无法容纳的地方。 没有记录原因的规则会被遵循,直到有人质疑它,然后被删除,这就是团队失去他们仍然需要的约束的方式——这与项目失去从未写下来的知识是相同的失败。
在 Schema 更改后重新审视。 描述 Schema 的项目知识会默默地过时,而过时的事实比缺失的事实更糟糕,因为它是自信地错误的。保持领域知识本身持久且可审查是使更新工作变得轻松的关键。
结论
Lovable 记录了两个知识层、每个知识层的字符限制、单一工作区层级、措辞委婉的冲突偏好,以及在极长对话中可能无法始终一致遵循指令的警告。在同一页面上,它记录了一个无论会话长度如何都始终会被读取的代码库文件。
综合来看,这些事实描述的是一个归档系统,而不是一种限制。按规则适用的频率对其进行排序:随时随地适用的每条消息放入工作区知识,仅在此处适用的每条消息放入项目知识,有时适用的放入技能。然后,将少数不一致遵循代价高昂的规则移入根目录下的 AGENTS.md。
消除重叠,测试衔接处,并在足够长的会话后重新测试。将每条规则背后的推理过程保存在能够经受住工具变更的地方,因为指令是配置,而决策才是资产——这就是团队在将 Lovable 项目迁移到其他地方并发现规则很容易复制而推理过程却很难复制时所发现的。