
为什么人们将 ChatGPT 对话移入 Codex
原因很实际。对话可以解释设计。而 Codex 是代理在你的代码库中工作、运行测试并进行更改的地方。OpenAI 对桌面应用两种模式的比较是这样描述的:Codex 让你“查看开发者详情,包括 diff 和评审视图”,而同一应用中的 ChatGPT 则偏好“非技术性语言和最终输出”。
因此,这种转变是自然的:在 Chat 中思考清楚,然后在 Codex 中执行。摩擦在于思考发生在一个地方,而工作发生在另一个地方。如果没有交接计划,你最终会不得不重新解释已经做出的决定。
ChatGPT 对话包含什么
引导至编码任务的对话可能包含四种上下文:
- 决策。 你选择了什么以及原因,以及你排除了什么。
- 约束。 版本、性能限制、团队规则、绝对不能更改的事项。
- 代码片段。 你粘贴的或 ChatGPT 编写的代码、错误消息和示例。
- 来自 ChatGPT 记忆的背景。 ChatGPT 根据你保存的记忆或对话历史记录所使用的偏好。
只有其中一部分存在于对话本身中。最后一项存在于 ChatGPT 记忆中,这是一个独立的系统。
OpenAI 的路径:从 Codex 的 New chat 中打开对话
在 ChatGPT 桌面应用中,Codex 有自己的侧边栏。OpenAI 的对比表显示,Codex 专注于“Codex 对话和开发项目”,而 ChatGPT 显示“在网页端和移动端使用 Chat 发起的对话,以及 ChatGPT Work 对话”。
桥梁就在 New chat 中。OpenAI 的项目指南指出,你可以从那里打开现有的 ChatGPT 对话“并将其添加到 Codex 对话中”。同一张表将 Codex 中的 Quick chat 描述为一种“在 Codex 中访问网页端和移动端 ChatGPT 对话”的方式(如果该选项可用)。
关于这条路径,有两点需要记住:
它是针对桌面应用的。 CLI 和 IDE 扩展是从目录运行的。OpenAI 表示“Codex CLI 将你启动它的目录视为对话的项目”,并且“CLI 不显示 ChatGPT 项目视图”。对于这些界面,对话内容必须通过其他方式到达 Codex,例如文件中的摘要。
添加对话是逐个进行的。 OpenAI 描述的是一次一个对话。如果十个对话引导到了当前任务,有用的内容就分散在十个地方,每个未来的 Codex 对话都需要重新添加它们。
如果你正在寻找某个对话,我们关于查找丢失的 Codex 对话历史记录的指南解释了每种对话出现在哪个列表中。
记忆是两个存储库,而非一个
OpenAI 的记忆指南开头就做了区分:“ChatGPT 网页端使用 ChatGPT 记忆,而本地 Codex 客户端使用独立的本地记忆存储和控制。”
因此,ChatGPT 从对话中了解到的关于你的任何信息都保留在 ChatGPT 记忆中。Codex 构建自己的本地记忆,且仅在你开启它们时才会构建:“本地 Codex 记忆默认关闭。”开启后,“Codex 可以将符合条件的先前对话中有用的上下文转化为本地记忆文件”,OpenAI 指出 Codex 会“跳过活跃或短暂的会话”并在后台更新记忆。
这些文件的去向取决于 Codex home。OpenAI 表示,在新的 home 中,“CLI 默认使用 $CODEX_HOME/memories_v2/”。我们关于 Codex 记忆 v2 的指南涵盖了这两个目录。
OpenAI 还明确了记忆的用途:“将记忆视为有用的召回层,而不是必须始终适用的规则的唯一来源。”规则属于 AGENTS.md。
每个部分在 Codex 中的归属
规则和约定放在 AGENTS.md 中
“Codex 在执行任何工作之前都会读取 AGENTS.md 文件。”OpenAI 描述了一个链条:Codex home 中的全局文件,然后是项目根目录到工作目录的文件,按此顺序连接。来自 ChatGPT 对话的约束(例如使用哪个库或哪个接口必须保持稳定)属于这里。代码库中的每个 Codex 对话随后都会以这些内容开始。
OpenAI 的项目指南对于本地工作也给出了同样的建议:“将持久的项目指南保存在 AGENTS.md 或签入的文档中,以便未来的对话可以使用。”如果 Codex 似乎跳过了你添加的规则,我们关于 Codex 跳过 AGENTS.md 规则的指南涵盖了大小限制和优先级问题。
决策放在签入的文档中
选择背后的理由可能比规则更长。在代码库中记录简短的设计说明,并从 AGENTS.md 链接过去,可以在不让每个提示词变长的情况下保留推理过程。
项目上下文需要单独迁移
如果对话存在于 ChatGPT 项目中,其部分上下文来自项目而非对话。OpenAI 表示“ChatGPT 项目使其对话能够访问相同的上传文件、项目指令和连接的源”。将对话添加到 Codex 对话会带入对话内容,但项目的指令和文件是单独的步骤。
在 Codex 中,项目的等效物是文件夹。OpenAI 表示“本地项目允许对话访问计算机上的一个或多个文件夹,例如源文件集合或代码库”。将项目指令复制到 AGENTS.md 中,并将对话依赖的参考文件放入代码库或附加到 Codex 项目的文件夹中。OpenAI 还指出,置顶对话“不会增加上下文或更改 ChatGPT 可以访问的内容”,因此置顶对话不能替代上述任何步骤。
代码片段放入任务中
来自对话的错误消息、示例和代码属于任务上下文。将它们粘贴到你开始工作的 Codex 对话中,或者在桌面应用中添加 ChatGPT 对话本身。
偏好放在 AGENTS.md 或 Codex 记忆中
ChatGPT 从记忆中获取的个人偏好(例如你喜欢的测试组织方式)可以放入你的全局 AGENTS.md。如果你希望 Codex 随着时间的推移学习它们,请启用 Codex 记忆,但要记住记忆文件是生成的状态。OpenAI 建议不要“依赖手动编辑它们作为你的主要控制手段”。
与导入有何不同
Codex 有导入流程,但其来源是其他代理。OpenAI 表示“桌面应用可以从 Claude Code、Claude Cowork 或 Cursor 导入。Codex CLI 可以从 Claude Code 或 Cursor 导入”。ChatGPT 对话通过 New chat 进入 Codex,如上所述。
ChatGPT Work 相关但也不尽相同。OpenAI 的项目指南指出“Work 对话历史记录与 Codex 历史记录保持分离”。我们关于 ChatGPT Work 模式的指南解释了 Chat、Work 和 Codex 共享哪些记忆、项目和历史记录。
人们首先尝试的方法
将整个对话粘贴到 Codex 中。 这对单个任务有效,但下一个 Codex 对话开始时就没有这些内容了。请将规则移至 AGENTS.md。
期望 ChatGPT 记忆跟随你进入 Codex。 根据 OpenAI 自己的描述,它们是独立的存储库。
在 Codex 侧边栏中寻找 ChatGPT 对话。 OpenAI 表示它们不会出现在那里。请从 New chat 中打开它们。
依靠 Codex 记忆来获取规则。 OpenAI 将记忆称为召回层,而不是必须始终适用的规则的唯一来源。
使用导入流程。 它用于从 Claude Code、Claude Cowork 和 Cursor 导入设置。
手动迁移
第 1 步:列出值得继续的对话
浏览关于该项目的 ChatGPT 对话,挑选出包含 Codex 所需决策或约束的对话。为每个对话写下两三行:决定了什么、原因以及哪些问题仍未解决。
第 2 步:将规则转化为 AGENTS.md
将约束添加到代码库的 AGENTS.md 中,如果它们适用于每个项目,则添加到全局 AGENTS.md 中。将较长的推理放入设计说明并建立链接。从代码库启动 Codex 并要求它总结当前的指令,以确认文件已加载。
第 3 步:启动附带对话的任务
在桌面应用中,从 New chat 启动一个 Codex 对话,并添加包含该任务详细信息的 ChatGPT 对话。在 CLI 或 IDE 中,将第 1 步中的代码片段和摘要粘贴到第一条消息中。对于较长的任务,我们关于导出 Codex 对话的指南展示了如何在之后保留一份工作副本。
更好的方法:将对话中的决策保存在一个你控制的列表中
手动迁移展示了 ChatGPT 对话的价值所在:在于分散在许多对话中的少数决策和约束。AGENTS.md 涵盖了代码库。其余部分,例如你为什么选择某种方法或你与团队达成的共识,仍然是分散的。
MemoryLake 是一个记忆层,用于将该列表保存在一个由你维护的地方,并提供给你连接的助手,如 ChatGPT、Claude Code 和 Codex。
你用自己的语言亲自编写条目。不会从你的 ChatGPT 对话、ChatGPT 记忆、Codex 对话、Codex 记忆、AGENTS.md 文件或任何供应商的存储库中读取、写入或删除任何内容。Codex 中的 New chat 和 ChatGPT 记忆将继续按照 OpenAI 描述的方式工作。
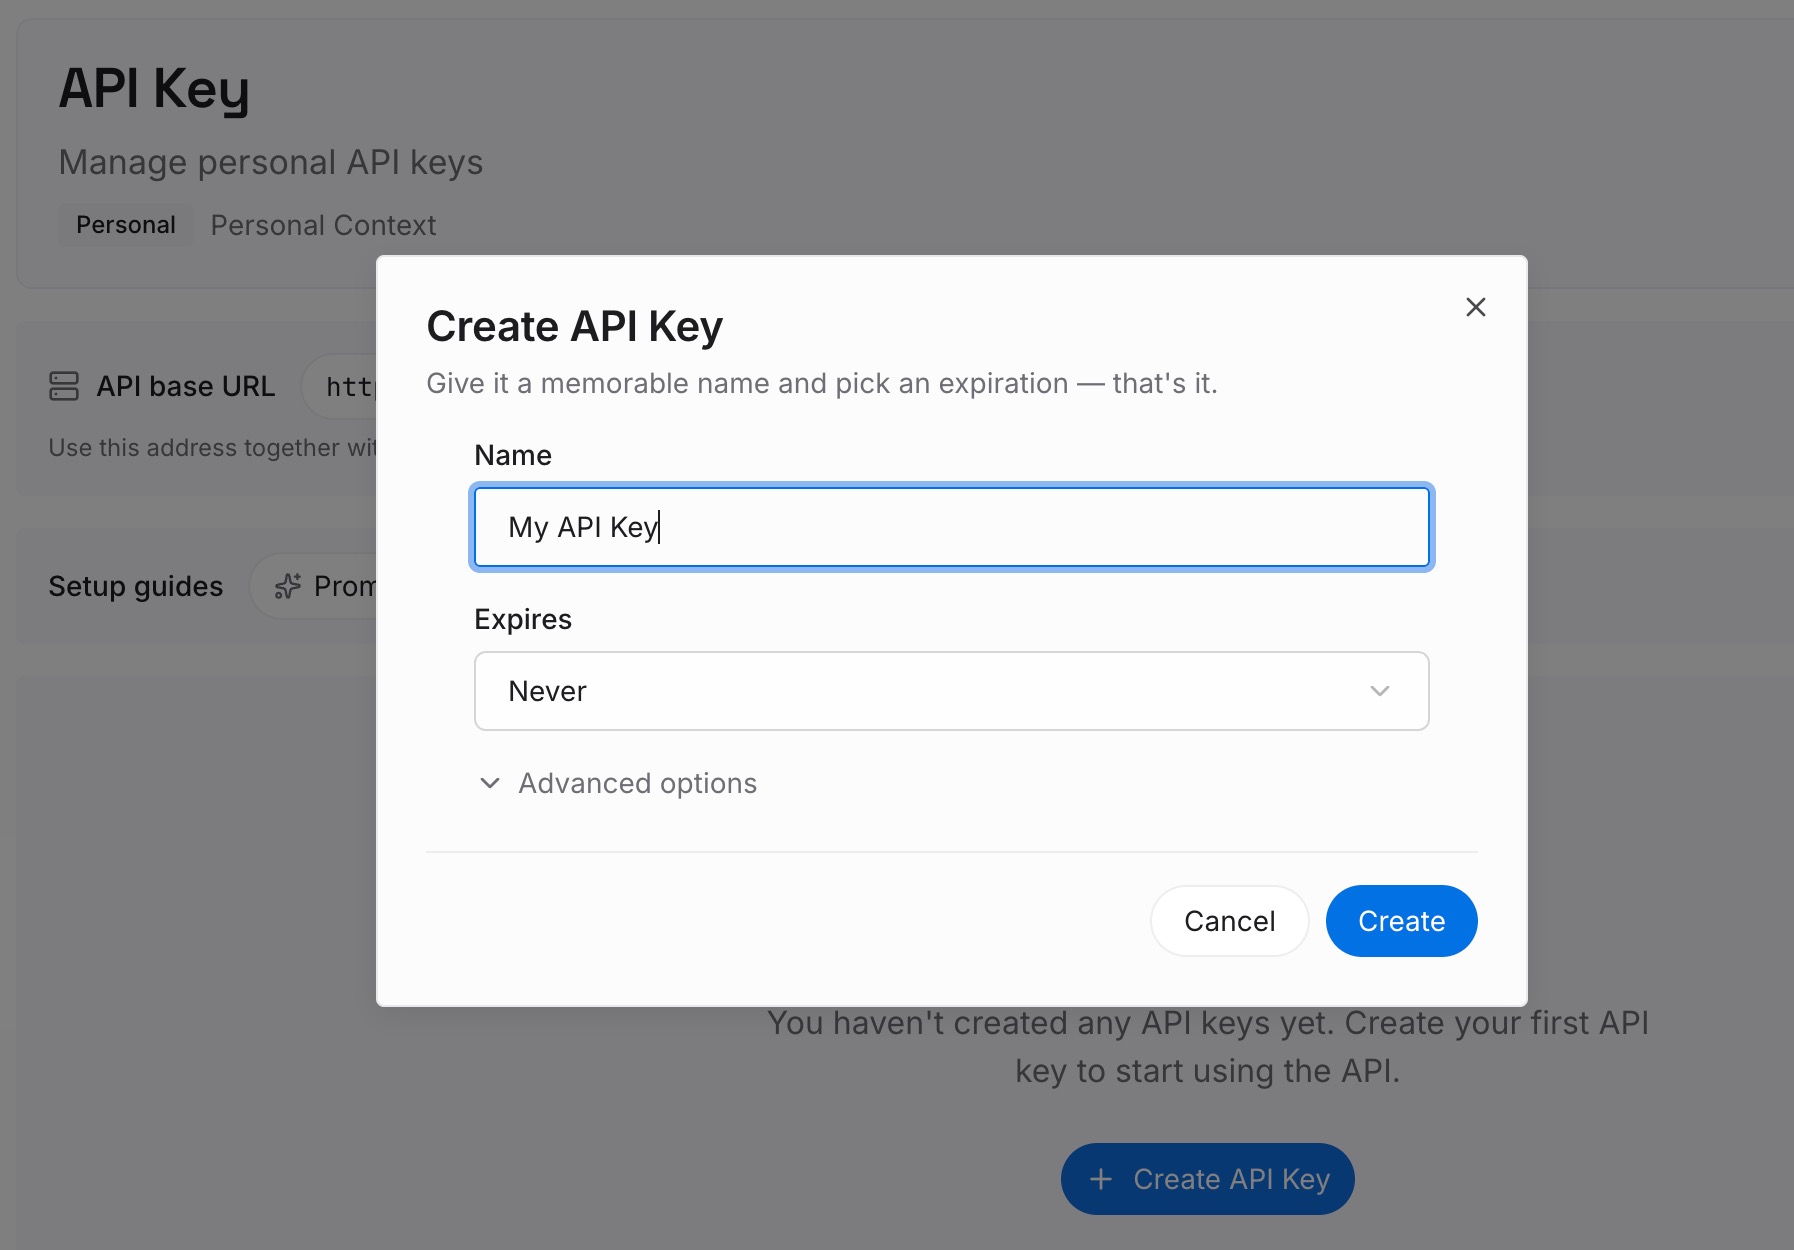
第 1 步:创建 API 密钥
登录并从仪表板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的 OpenAI 账户是分开的。
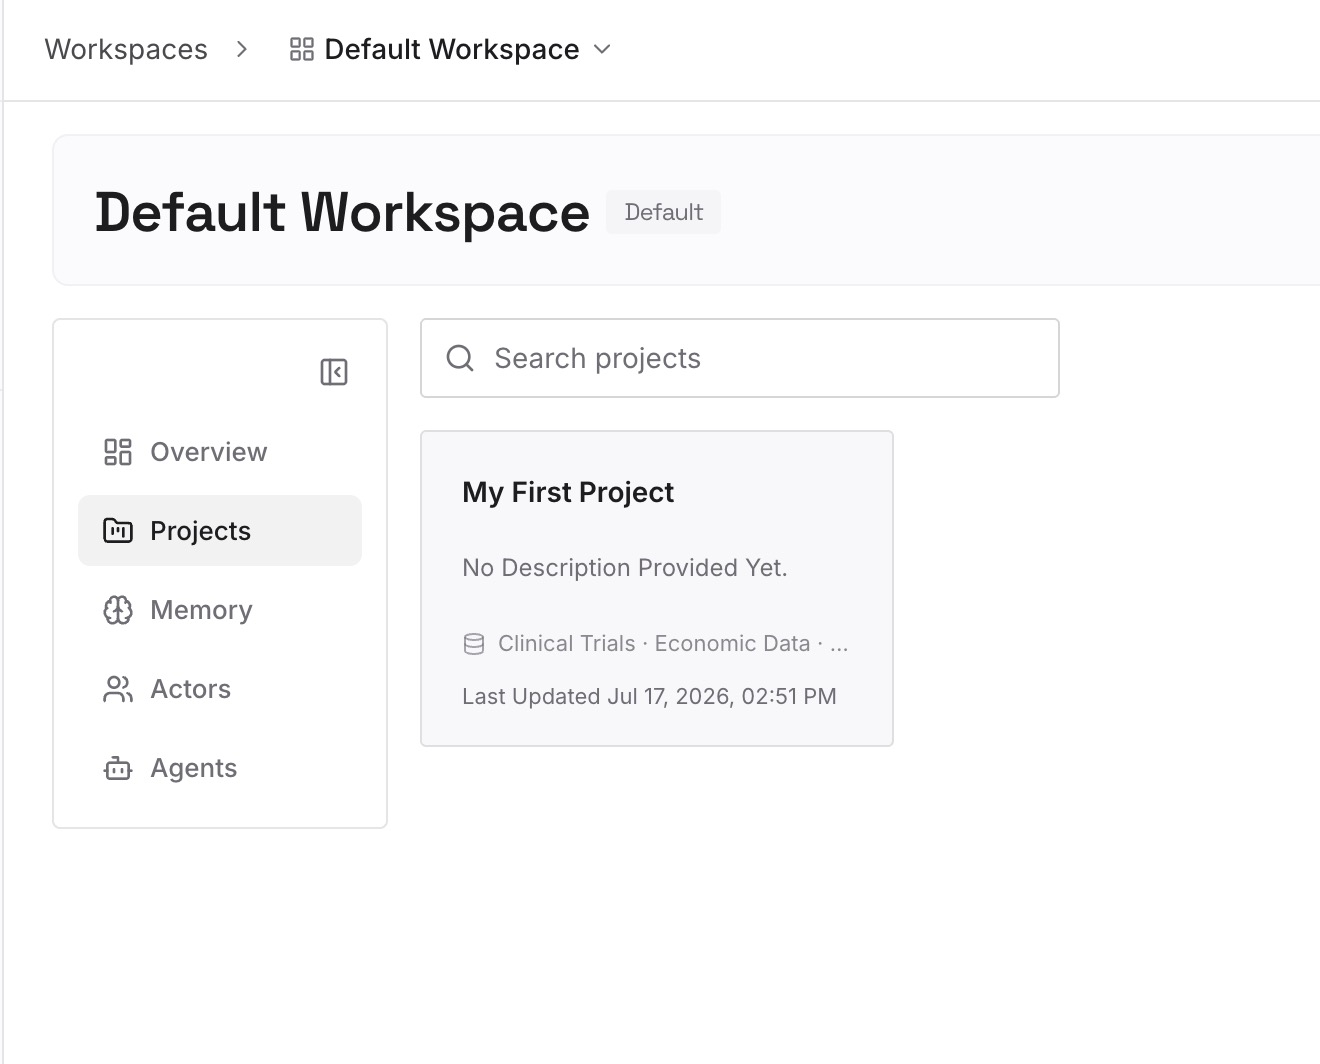
第 2 步:上传你的第一批记忆
从你在手动迁移第 1 步中编写的摘要开始:决策、原因和未决问题。每个条目一个要点,并注明日期。
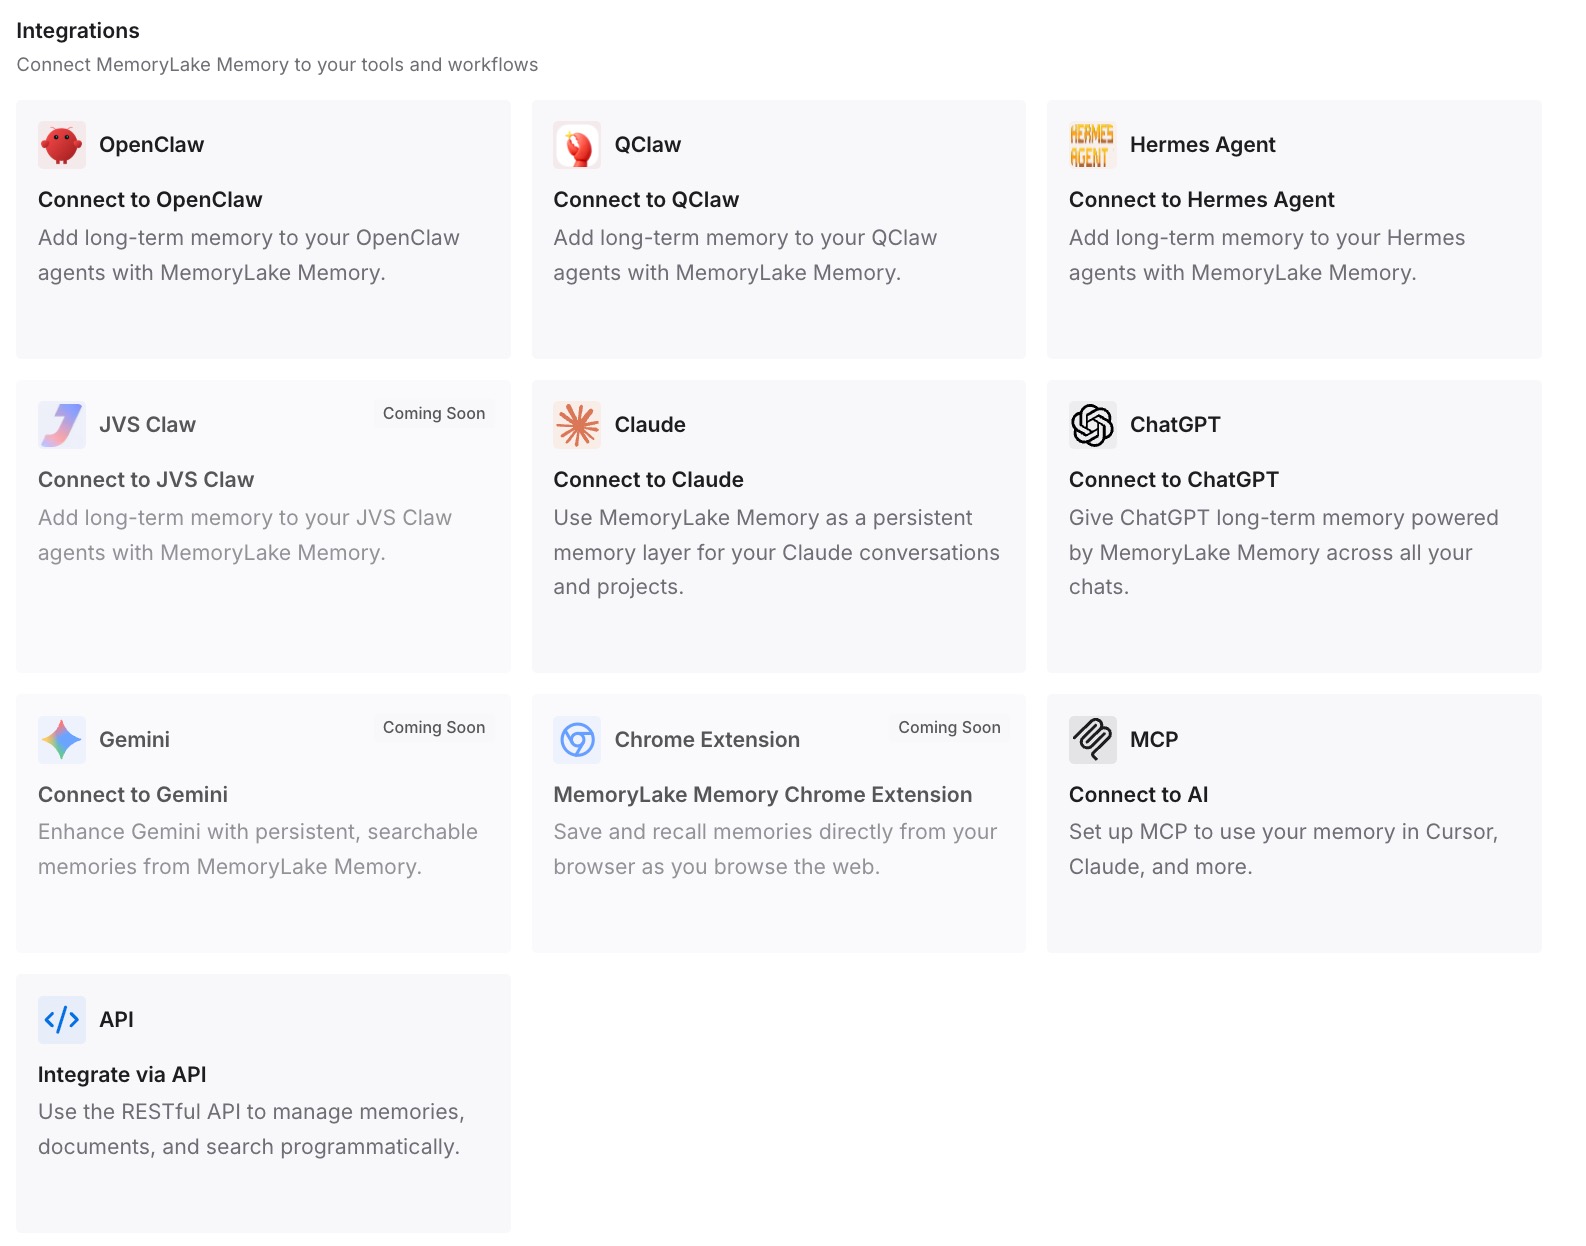
第 3 步:连接你的 AI 和代理
连接 ChatGPT 和 Codex,以及你使用的任何其他助手。无论你是在 Chat 中思考还是在 Codex 中执行工作,都可以使用相同的条目。
这在实践中改变了什么
第一个区别是第一条消息更短了。Codex 以 AGENTS.md 开始每个对话,其背后的决策只需一次查找即可获得,因此你无需在每个任务中粘贴相同的背景信息。
第二个区别是丢失理由的情况减少了。你做出决定的那个对话可能会滚出视线,但你编写的条目会保留在你放置的地方。
第三个区别是切回时工作量减少。当下一个问题再次是设计问题时,ChatGPT 拥有与 Codex 相同的条目。
将 ChatGPT 对话移至 Codex 的最佳实践
迁移规则,而非对话记录。 将约束放入 AGENTS.md 并将对话保留为参考。
在桌面应用中使用 New chat。 添加包含任务详细信息的 ChatGPT 对话。
在离开对话前进行总结。 每个对话两三行摘要比携带整个对话更容易。
慎重决定 Codex 记忆。 它们默认关闭并存储在本地。
在头脑中将 ChatGPT 记忆和 Codex 记忆分开。 它们是独立的存储库。
检查 AGENTS.md 是否加载。 要求 Codex 总结当前的指令。
不要手动编辑记忆文件。 OpenAI 将其视为生成的状态。
结论
ChatGPT 对话和 Codex 对话存在于不同的列表中,ChatGPT 记忆和 Codex 记忆是不同的存储库。在桌面应用中,你可以从 New chat 中打开现有的 ChatGPT 对话并将其添加到 Codex 对话中,这涵盖了一个任务。在 CLI 和 IDE 中,内容必须通过第一条消息或文件到达 Codex。
对于你希望每个未来的 Codex 对话都知道的任何内容,OpenAI 的建议指向 AGENTS.md 和签入的文档。从对话中提取决策,将规则放在 Codex 读取的地方,并将理由保存在你可以再次找到的地方。