
实际转移了什么
Perplexity 自身的定义界定了其范围:“记忆(有时被称为个人搜索)是一项允许 Perplexity 在对话之间记住细节的功能,使您的交互更加个性化和高效。”
然后,它将其拆分为两个不同的调用来源。第一种是记忆(Memories)——“您与我们分享的偏好、兴趣和信息,这将有助于 Perplexity 在未来提供更明智的回答。”第二种是搜索历史(Search history)——“在某些场景下,参考过去的问题、回答等有助于为您提供最相关的响应。”
这种拆分并非流于表面,其后果也被直接指出:
“为了让您对两者拥有终极控制权,其权限是分开的。关闭‘记忆’并不会清除您的记忆,删除历史记录中的对话线程也不会。”
两个开关,两个存储库,任何一个开关都不会清空任何内容。如果您曾经关闭过记忆,以为这就是重置,然后纳闷为什么重新开启时个性化又回来了——这就是文档中记录的行为,而不是 Bug。
记忆库是如何构建的,对于您应该保留什么内容更为重要。Perplexity 将其描述为在使用中积累:“当您在 Perplexity 中提出问题或表明偏好时,我们将使用这些信息来存储关键记忆。”然后是来自敏感信息章节的重要限定条件:“记忆是基于一个偏好用户提问和提供信息频率的模型生成的。”
频率。而不是重要性。您在三月份询问过十一次的事情得到了很好的体现;而您只声明过一次、却主导着一切的约束条件,可能根本不存在。这是规划此次迁移最有用的一点,它告诉您,迁移实际上是一次审计。
现在,让我们一步步来看具体机制。
您的记忆列表可以转移,因为您可以看见它。 Perplexity 文档中记录了在账户“设置”(Settings)的“个性化”(Personalize)板块下查看它们,然后通过“管理记忆”(Manage Memories)来查看和删除已保存的记忆。帮助文章描述了查看和删除的操作;但并未提及可以下载的文件,因此请计划阅读列表并记录下重要的内容,而不是直接导出。
您的搜索历史只有在您的对话线程仍然存在时才能转移。 这就是陷阱。Perplexity 文档指出,某些线程是临时的且会过期:“未登录线程是在未登录账户的情况下创建的线程。这些匿名线程将在 14 天后过期且无法恢复”,以及“无痕线程是私密对话,将在 24 小时后过期。”如果您使用 Comet,范围会进一步扩大:“当您的查询涉及打开的标签页、浏览历史记录或触发智能体事件时,临时线程将始终过期。”
无痕模式中的任何内容都从未进入过记忆库。 Perplexity 的表述非常明确:“使用无痕模式时,记忆和以前的搜索始终处于关闭状态,在无痕模式下提出的问题绝不会被保留或用于记忆中。”很好的隐私设计,这也意味着您以这种方式进行的任何研究,仅存在于您自己保存的内容中。
引用线索无法转移。 Perplexity 会展示其工作过程——当您获得回答时,被引用的记忆和以前的搜索会出现在来源中。这种出处是 Perplexity 回答界面的一项属性。您能带走的是结论,并在句子中写明来源名称。
现在来看看目的地。ChatGPT 文档中记录的个性化界面包括 Custom Instructions(自定义指令)、记忆摘要以及传统的已保存记忆系统。OpenAI 将这项工作分摊在它们之间:“对于明确的信息或指令,您可以将其添加到 Custom Instructions 中。对于通过对话分享的信息,ChatGPT 可以为您记住相关细节。”在传统列表上,它对时间做出了明确说明——“除非您删除它们,否则在未来的回答中始终会考虑已保存的记忆”——并且它警告说,可见的摘要是不完整的:“虽然记忆摘要应该捕获最重要的细节,但它不会包含 ChatGPT 根据您的聊天所记住的所有内容。”
因此,双方都有一个可见层和一个推断层。可见部分可以清晰地映射。而推断部分在任何方向上都完全无法转移——这正是为什么“记录下来”是这里的全部工作。
如果您要迁移的是 Spaces(空间)而不是记忆库,那是另一种具有不同形态的资产,具体请参阅将 Perplexity Spaces 迁移到 ChatGPT。如果促使您进行此操作的原因是达到了上限而不是更换工具,那么上限本身已在解决 Perplexity 记忆限制的最佳方法中进行了介绍。
手动迁移
Step 1: 在更改任何设置之前,先阅读两个存储库
打开“设置”(Settings),转到“个性化”(Personalize),然后打开“管理记忆”(Manage Memories)。阅读整个列表。不要走马观花——这是您唯一一次获取清单的机会,而且 Perplexity 已经告诉过您它是按频率组装的,所以请像阅读搜索日志而不是个人资料那样去阅读它。
在阅读过程中,将每个条目分类到三个桶中。
真实且起支撑作用的。 您的领域、您的约束条件、您实际遵循的规范。这些将与您同行。
真实但琐碎的。 对某种美食的偏好、一次性的对比、您为朋友研究的事情。留下它们。将这些复制到新工具中,会让全新的记忆库在第一天就变得杂乱无章。
错误或已过期的。 按频率加权的存储库会积累这些内容。您已离开的项目、您停止使用的工具、两个职位前的偏好。记录下它们,因为它们最有可能在暗中影响了您所信赖的回答。
然后进行第二轮,这是人们常常忽略的一步:浏览您的库,找出重要的对话线程,并从中提取结论。Perplexity 的线程是推理存在的地方,其中一些线程的过期日期并非由您选择。在进行任何删除操作之前完成此步骤,因为从库中删除所有线程在文档中被记录为不可逆的操作。
在此期间,请检查第二项权限。引用记忆和引用搜索历史是分别切换的,关闭其中一个并不会清除另一个。
Step 2: 通过 ChatGPT 文档中记录的两个界面进行重建,然后进行验证
关于您的长期指令和稳定事实应放入 Custom Instructions 中,OpenAI 将其描述为存放明确信息和指令的地方。保持精简;这在每一次回答中都会起作用。
所有情境化的内容都会在您使用时存入,这也是 OpenAI 描述的另一半工作方式——在对话中分享的细节,为您保留。这意味着重建不是一次简单的粘贴。而是在一周的正常使用中,有意识地将重要的事情说一遍。
然后进行验证,并使用 OpenAI 指定的方法,而不是盲目相信列表。其指导非常直接:“如果您想知道 ChatGPT 是否记住了某些内容,只需在聊天中询问即可。”可见的摘要并不是一份清单——OpenAI 自己也这么说:“不一定。ChatGPT 的记忆是基于对您过去聊天中上下文的不断更新的综合,这可能比摘要中显示为单个项目的范围更广。”这种差距在日常使用中意味着什么,已在ChatGPT 记忆摘要遗漏了什么中进行了讨论。
一个关于日程的注意事项:如果您在临时聊天(Temporary Chats)中进行重建,任何内容都不会生效。OpenAI 文档指出,临时聊天既不使用现有记忆,也不创建新记忆。
更好的方法:将您整理的列表保存在频率模型无法重写的地方
您刚刚做了一件很有价值但也略显痛苦的事情:您阅读了一份机器生成的个人画像,并决定了哪些部分是真实的。这种判断就是资产。如果您将其留在您碰巧正在使用的任何存储库中,它也会随之蒸发,因为这两个存储库的设计初衷都是为了不断自我更新。
因此,将整理后的版本保存在您自己的地方。不是原始列表,而是您修改后的版本。
这就是 MemoryLake 的用途。您可以用自己的语言亲自将条目写入其中,并附上每个条目之所以重要的原因,您连接的每个助手都会读取相同的数据集。没有任何内容是从任何厂商的存储库中提取的;里面的内容完全由您决定。
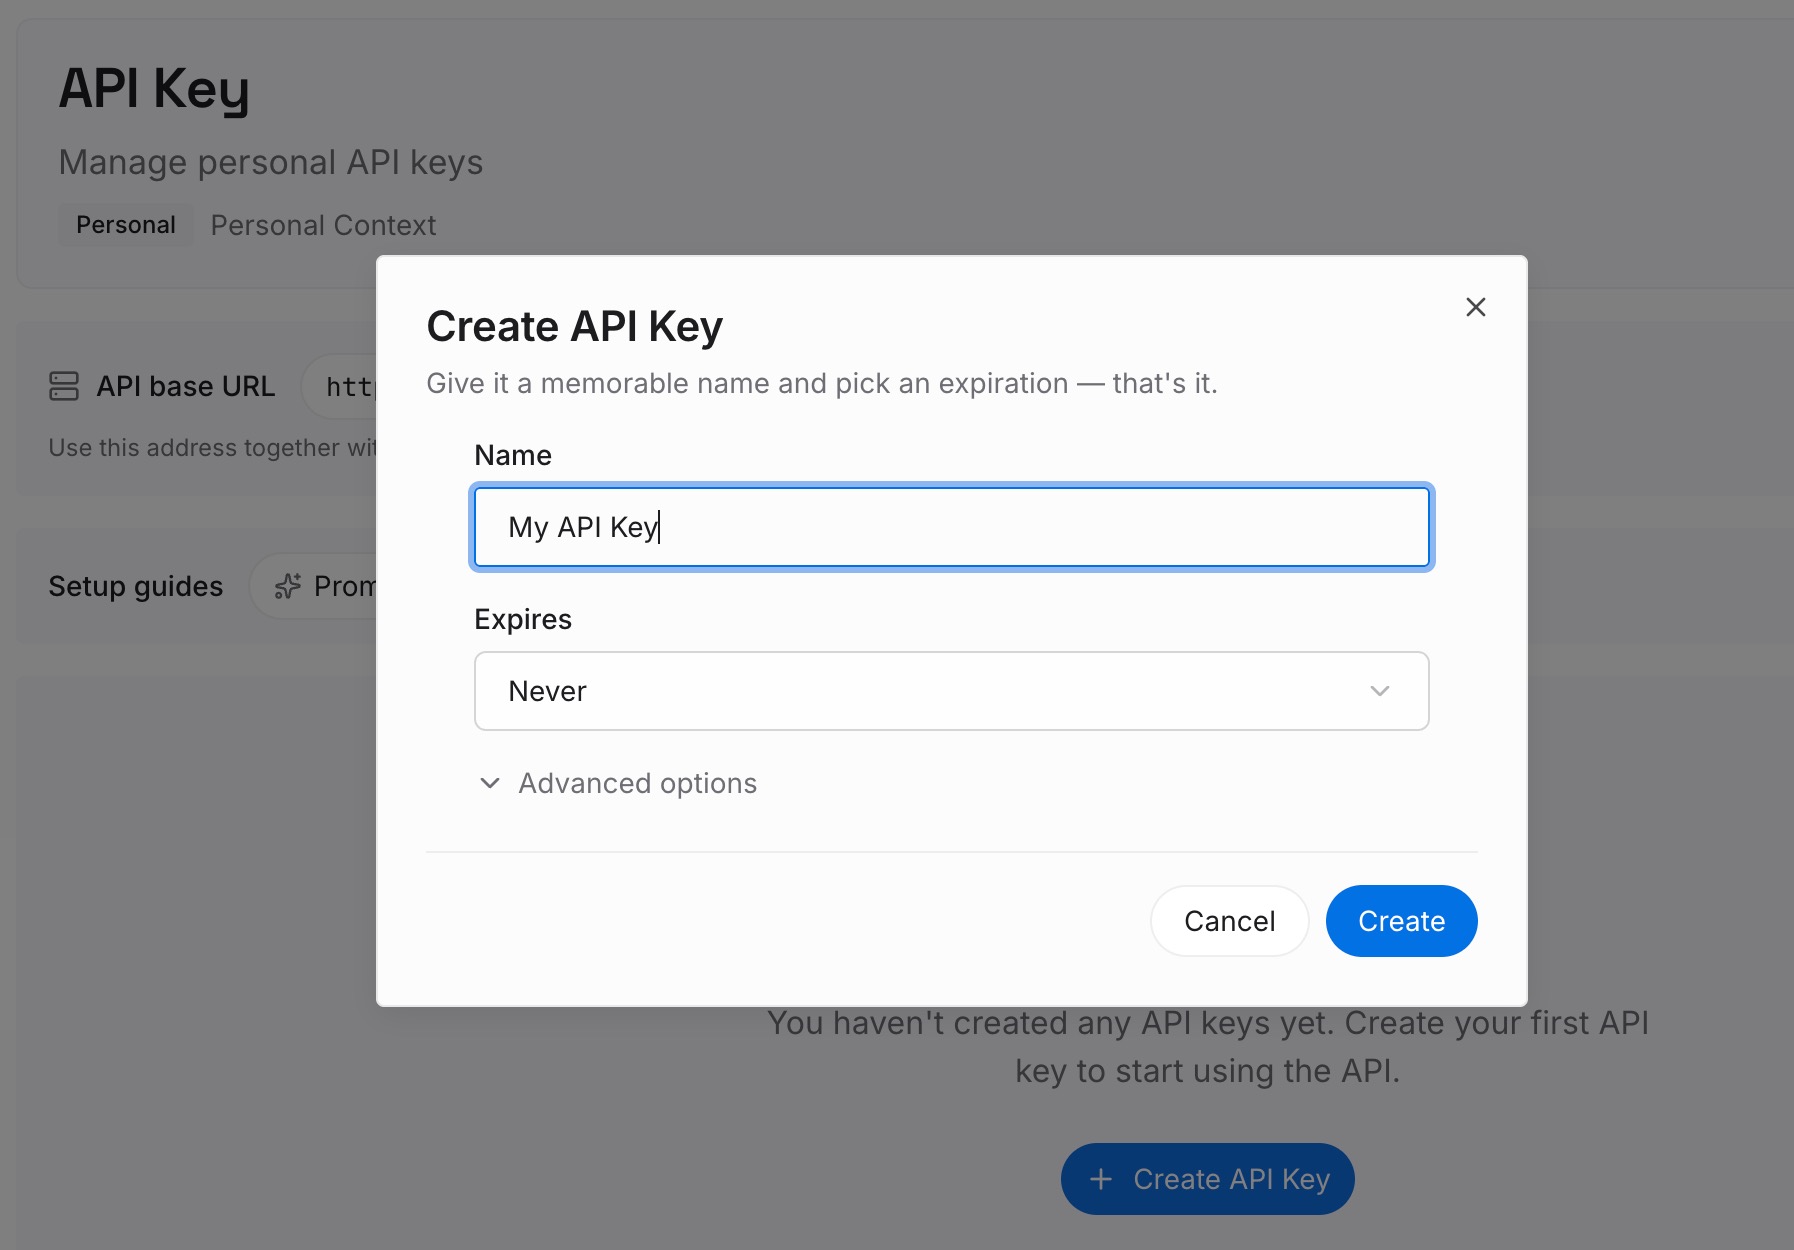
Step 1: 创建 API 密钥
登录,打开您的工作区设置,并生成一个 API 密钥。这是您的助手用来读取同一层数据的凭证,因此只需创建一次,并确保在您进行研究的每个工具中都可以访问到它。
Step 2: 上传您的第一批记忆
从您审计中筛选出的起支撑作用的记忆开始,每个主题一个条目,并附带其原因。添加那些重新发现成本高昂的约束条件:当两个来源不一致时您信任哪一个,您已经解决关闭了哪些问题,过去六个月的阅读实际上得出了哪些结论。
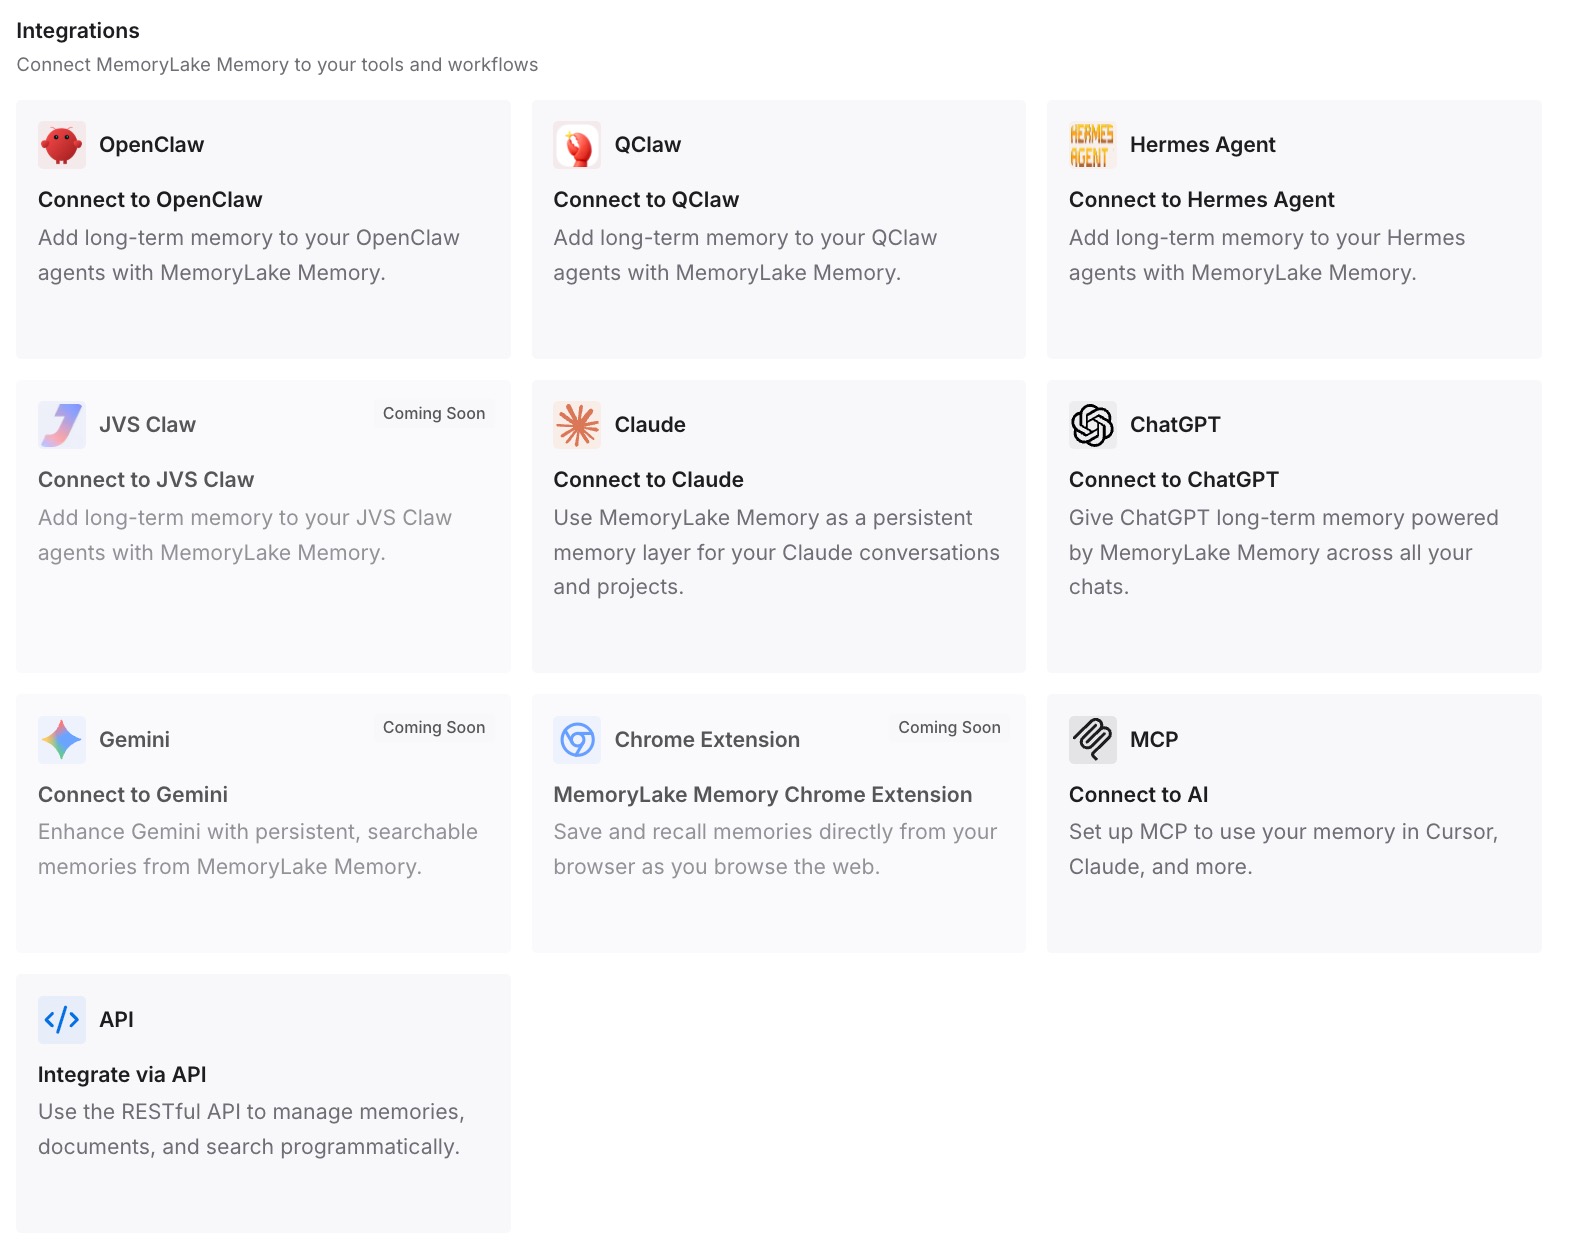
Step 3: 连接您的 AI 和智能体
连接 ChatGPT 以及您在其中工作的任何其他工具。相同的整理好的数据集会同步到每个工具中,因此新线程在开启时就已经知道您的决定,而不是您碰巧最常询问的内容。
这在实践中改变了什么
第一个区别是,频率不再决定您是谁。您刻意撰写的记录表达了您的真实意图;而通过重复推断出的记录则表达了您所询问的内容。这两者是不同的,而且其中只有一种值得在工具之间传递。
第二个区别是,过期的线程不再带走结论。临时线程、未登录线程和无痕模式都是合理的功能,但它们都不是保留决定的地方。一旦决定存在于其他地方,过期就只是日常清理,而不是损失。
第三个区别是,切换不再是一件大事。任何曾反向进行过此迁移的人——即将 ChatGPT 记忆迁移到 Perplexity中所述的路径——都知道每次的工作都是相同的,如果整理后的版本存在于两者之外,那么只需操作一次即可。
第四个区别是,研究本身变得更有粘性。在当 Perplexity 遗忘您的研究上下文时中的抱怨很少是因为遗漏了某个事实,而是因为在提出下一个问题之前,必须重新确立该项目是什么。
迁移记忆库的最佳实践
复制前先审计。 按频率加权的列表是日志,而不是个人画像。将其视为您所提问题的证据,然后独立决定什么是真实的。
在偏好旁边写下原因。 “偏好一手来源”是一个设置。而“偏好一手来源,因为行业媒体一直在误报 2025 年的规则变化”则是人或助手可以执行并在以后检查的内容。
在删除任何内容之前提取线程。 从库中删除所有线程在文档中被记录为不可撤销的操作,而且有些线程根本不需要删除就会自动过期。
检查两项权限,而不仅仅是一项。 记忆和搜索历史引用是独立的开关,Perplexity 指出关闭记忆并不会清除您的记忆。
刻意排除敏感细节。 Perplexity 表示已采取措施降低记忆保留健康或财务细节等内容的可能性,并且您可以查看和清除记忆库。请将此视为底线,而不是保证,并主动将任何真正敏感的内容排除在任何助手的记忆之外。
预料到目的地的列表可能不完整。 OpenAI 表示摘要不会包含所有内容,并建议您在聊天中询问。实际后果已在ChatGPT 的记忆限制中阐明。
结论
Perplexity 在这方面的设计很坦诚。它分离了权限,以便您可以在不擦除存储库的情况下控制引用,它告诉您记忆是由一个偏向频率的模型生成的,并且公布了哪些线程会在何时过期。极少有厂商会主动提供这么多信息。
但迁移过程依然会令人痛苦,因为您要迁移的从来都不是一份文档。它是机器对您产生的印象,由您询问事情的频率组装而成,存放在两个带有两个开关的存储库中,并伴随着悄然过期的线程。
因此,做好审计,保留修改后的版本,并将其放在任何厂商的模型都无法重写的地方。无论您接下来使用什么工具,列表都会重新生成。而关于其中哪些部分是真实的判断,只有在您将其记录下来时才会存在。