
为什么插入顺序不是优先级排序
以下是原汁原味的定义:
“数值。定义了当多个条目同时激活时的优先级。具有较大顺序数值的条目将被插入到更接近上下文末尾的位置,因为它们对输出的影响更大。例如,顺序数值为 100 的条目将比顺序数值为 250 的条目更早出现在上下文中。”
数字越大,位置越靠后,影响越大。数值为 250 的条目排在 100 之后,并且更接近模型即将生成文本的位置。如果您将世界的核心规则编号为 1,而将一个无关紧要的小酒馆编号为 400,那么这个小酒馆才是最吸引模型注意力的东西。
这是第一项工作。第二项工作在文档的一个完全不同的章节中,即“激活设置”(Activation Settings),而这正是长会话中容易让人踩坑的地方:
“如果预算耗尽,即使提示词中存在关键词,也不会再激活更多条目。”
“常驻条目(Constant entries)将首先被插入。然后是具有较大顺序数值的条目。”
因此,同一个数字还决定了谁能存活。一旦世界信息(World Info)预算耗尽,激活就会停止——即使关键词匹配、条目符合条件,也不会插入任何内容。最先进入的是常驻条目,然后是数值范围从高到低的其他所有内容。您设为 1 的条目在空间排队中垫底,在注意力排队中也垫底。
同一章节中的另一行内容改变了您对递归设定(recursive lore)的看法:“通过直接提及关键词插入的条目,其优先级高于在其他条目内容中被提及而触发的条目。” 也就是说,通过递归拉入的条目排在由实际对话触发的条目之后。
还有一个细节解释了大量的无声失败。文档中指出,条目标题(Entry Title)是“一个为了方便您标记条目的文本字段,AI 或任何触发逻辑都不会使用它”。高级技巧中说得更宽泛:“激活关键词、标题以及其他不在‘内容’(Content)字段中的信息不会被插入到上下文中,因此每个世界信息条目都应该有一个完整的、独立的描述。”如果您的标题承载了实际含义,那么其实从来没有任何东西读取过它们。
这正是 为什么智能体忽略您的指令文件 中描述的问题的普遍形式——文件存在,文件正确,但文件根本没有送达模型。
人们尝试的其他替代方法
将所有内容重新编号为 1。 如果所有内容都最重要,那么平局决胜就变得随机,而且预算仍然会在某个地方截断列表。您并没有排出优先级,而是剥夺了自己排出优先级的能力。
将每个关键条目都设为常驻。 蓝圈策略意味着条目“不需要任何关键词,无论内容如何都会触发”。这确实有效,但它会在考虑任何条件条目之前花光您的全部预算——文档中明确指出常驻条目会最先插入。三四个是合理的计划,二十个就会让预算毫无余地。
写更短的条目并止步于此。 这有用,但它针对的是错误的变量。长度影响能容纳多少条目;顺序影响哪些条目能获得空间以及它们落在哪里。缩短一切方法的局限性与 您应该给 AI 智能体多少记忆 中讨论的局限性相同。
提高预算直到不再报错。 这将设定问题转化为了上下文问题。更大的世界信息配额意味着聊天记录的空间变小,这就是 为什么长上下文不等于记忆 中描述的权衡——提示词中更多的空间并不等于更多的记忆,只是对同一个架子进行了不同的分配。
将条目切换为向量匹配以规避整个问题。 SillyTavern 对此付出的代价非常坦率:“由于检索质量完全取决于嵌入模型的输出,因此无法准确预测将插入哪些条目。如果您想要确定且可预测的结果,请坚持使用关键词匹配。” 向量匹配也仅仅取代了关键词检查——预算、概率、过滤器和包含组(inclusion groups)仍然适用。这种权衡的更广泛版本(用相似度搜索代替您可以写下来的决策)在 为什么 RAG 不等于记忆 中有详细介绍。
解决方案:根据您希望它被读取的先后顺序进行编号,然后检查预算实际能覆盖到哪里
步骤 1:按邻近度分段重新编号
停止思考“排名”,开始思考“这应该离模型的下一句话有多近”。
为自己设置三到四个留有宽间距的区间,这样您以后就可以直接插入新条目而无需重新编号。低数值用于应该尽早确立的背景——世界物理法则、时代、宽泛的设定。中等数值用于关于地点和派系的常驻事实。高数值用于在模型写作前最后读取的内容:活跃的剧情限制、关于角色绝不会做什么的硬性规则、当前场景的利害关系。
宽间距比精确数值更重要。以 100 为间隔的区间为新条目留出了插入到两个现有条目之间的空间,而无需进行全局重新编号。
然后检查您的设定插入策略(Lore Insertion Strategy),因为它改变了数字对比的基准。默认是“均匀排序”(Sorted Evenly),SillyTavern 将其描述为“根据所有条目的插入顺序进行排序,就好像它们是一个大文件的一部分,忽略来源”。替代方案“角色设定优先”(Character Lore First)和“全局设定优先”(Global Lore First)在应用每个组内的顺序之前,先按来源进行分组。如果您的角色设定集和全局设定集使用不同的编号约定,“均匀排序”会以作者未曾预料的方式将它们交织在一起。
另请注意,与聊天绑定和与人设绑定的设定完全在这项对比之前插入,顺序为文档所述:聊天设定,然后是人设设定,最后是根据所选策略的角色或全局设定。
步骤 2:将位置与顺序分开,因为它们是不同的控制项
插入顺序(Insertion Order)决定已激活条目之间的先后顺序。插入位置(Insertion Position)决定条目落在提示词的哪个区域,SillyTavern 注释了每个位置的影响。
“在角色定义前”(Before Char Defs)被记录为对对话有“中等影响”。“在角色定义后”(After Char Defs)具有“更大影响”。示例消息(example-message)位置被解析为示例对话块,并遵循示例消息规则,这意味着随着上下文填满,它们可能会被挤出。作者附言(Author's Note)位置带有一个文档用叹号标记的陷阱:“如果您的作者附言被禁用(插入频率 = 0),A/N 位置的世界信息条目将被忽略!” 一个条目可能写得完美无缺、关键词正确、顺序靠前,却因为一个完全不同的功能被关闭而被默默丢弃。
深度位置(depth position)是这里最锋利的工具——将条目插入到聊天中的特定深度,深度为 0 代表提示词的最底部,并可选择系统(system)、用户(user)或助手(assistant)角色。这就是您如何在不使其常驻的情况下,在生成前立即加入硬性约束的方法。
如果您想要完全控制,插槽(Outlet)位置会完全移除自动注入,并将内容存储在您自己放置的命名标记(token)下。文档列出了实际的注意事项:插槽名称区分大小写,在调用宏时会忽略名称中的前导或尾随空格,因此带有填充空格的名称将无法匹配,不支持嵌套,且角色卡字段无法展开插槽,因为它们会被提前解析。
步骤 3:通过观察哪些内容被丢弃来验证,而不是通过阅读面板
正确的条目和已插入的条目是两码事,而面板只向您显示前者。
运行一个应该同时触发多个条目的场景,并查看实际送达的内容。如果一个高顺序条目出现而一个低顺序条目没有出现,您就找到了您的预算上限,并且现在知道排序正在发挥作用。如果根本没有条件条目送达,请先清点您的常驻条目。
刻意测试包含组(inclusion groups),因为它们的行为常常让人感到意外:“如果激活了具有相同组标签的多个条目,则只有一个会被插入到提示词中”,这由组权重(Group Weight)决定,除非您启用了“优先包含”(Prioritize Inclusion),在这种情况下“将选择具有最高‘顺序’(Order)值的条目。” 这是您的顺序数值可以承担的第三项工作,并且它是可选的。
在归咎于顺序之前,还要检查任何带有定时效果的内容。粘性(Sticky)使条目在设定的消息数量内保持激活状态,并在持续期间忽略概率检查;冷却(cooldown)在设定的消息数量内阻止重新激活;延迟(delay)在聊天足够长之前阻止激活。还要检查扫描深度(Scan Depth),因为在 0 时“仅评估递归条目和作者附言”——如果根本不扫描关键词,再正确的编号也无济于事。
这与 审计您的 AI 记住了什么 中的原则相同:通过观察输出来验证,而不是通过阅读配置。
在 MemoryLake 中进行设置
通过这次练习可以得出两件事,而其中只有一件属于设定集。条目本身是 SillyTavern 的工作,它做得很好。而背后的逻辑——为什么这条规则优于那条规则、哪个约束绝不能丢弃、当条目默默停止触发时您学到了什么——在数字字段中无处安放。
MemoryLake 承载了这第二层,独立于任何单一的前端。您用自己的话亲自编写它,当您更换工具、重建设定集或将世界移交给他人时,它依然保持可读。
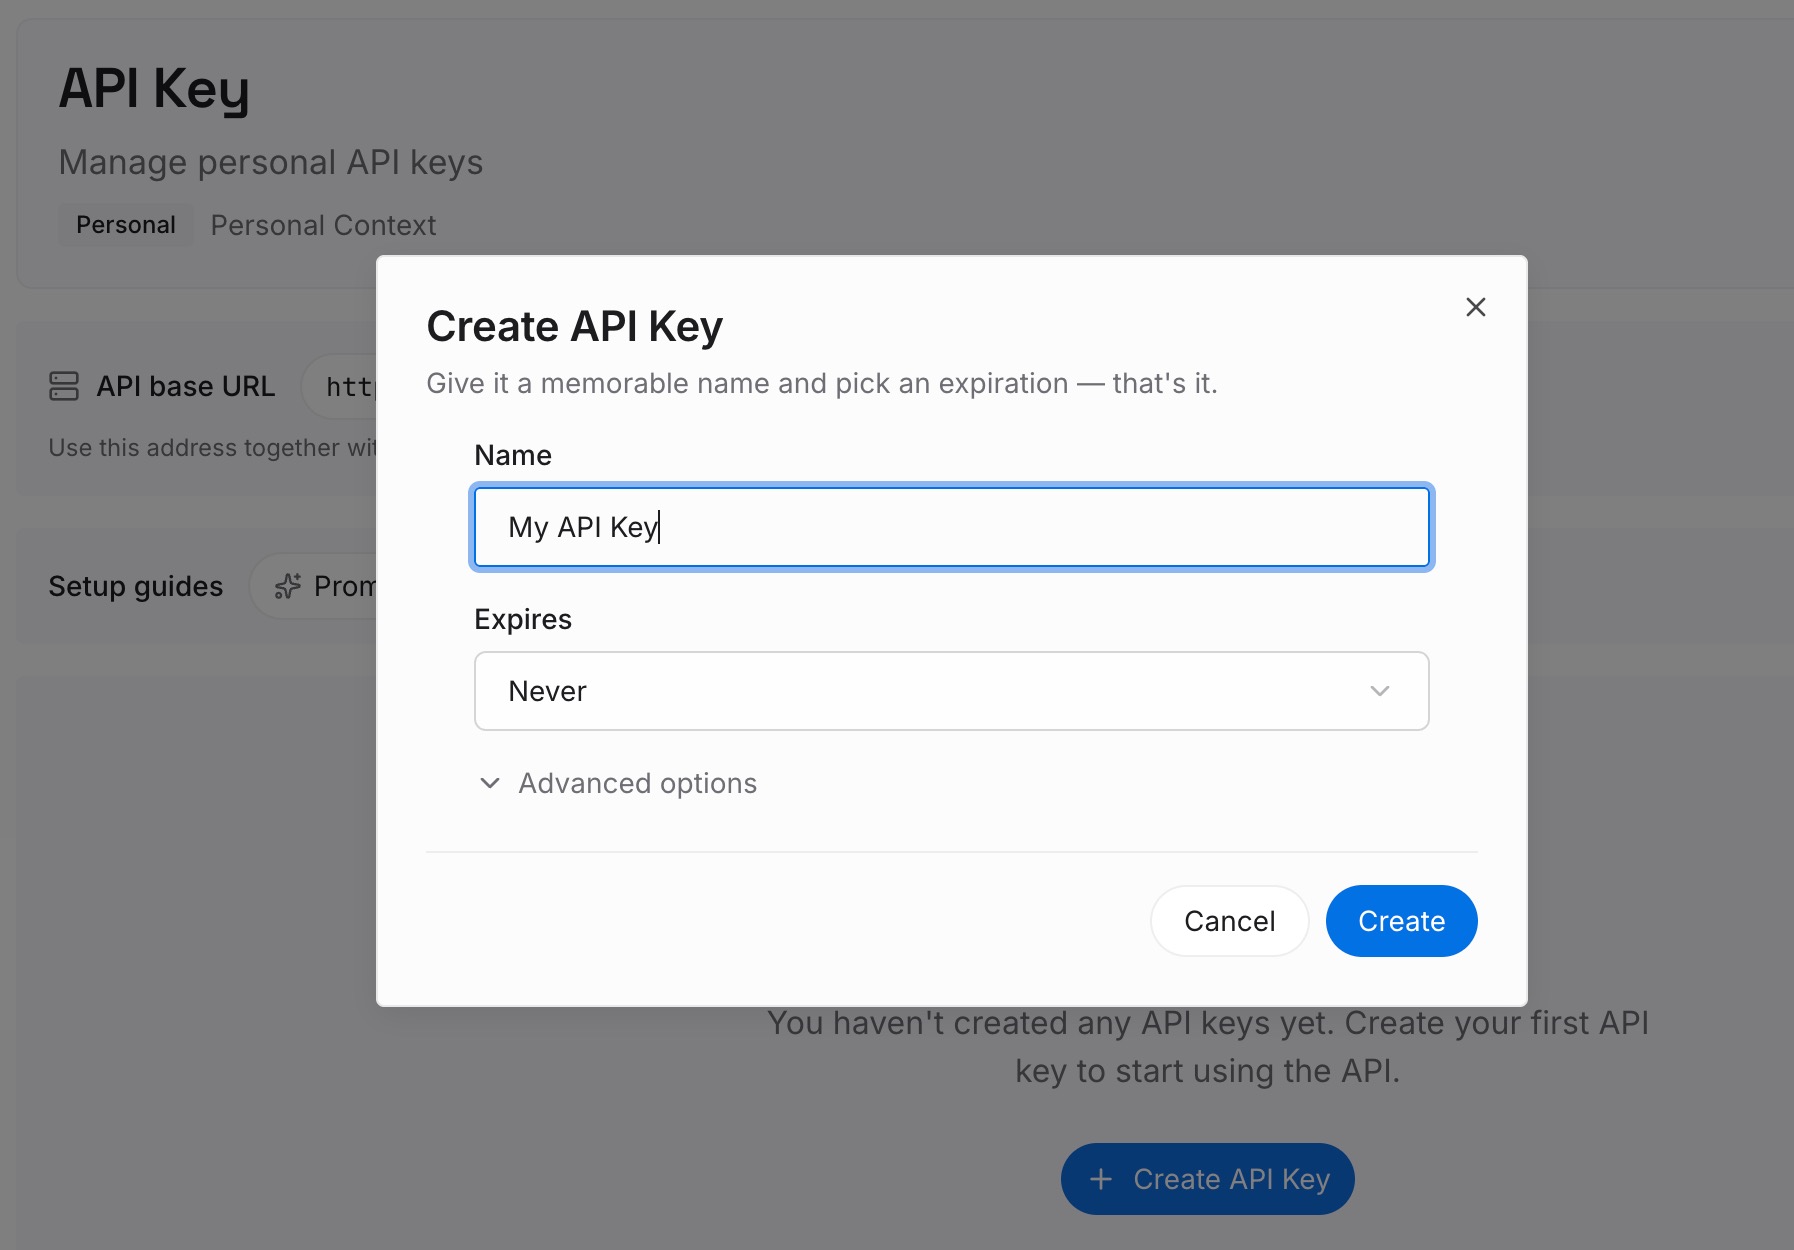
步骤 1:创建 API 密钥
登录,打开您的工作区设置,并生成一个 API 密钥。这是您的助手用来读取同一层的凭证,因此只需创建一次,并确保在您写作的每台机器上都能访问它。
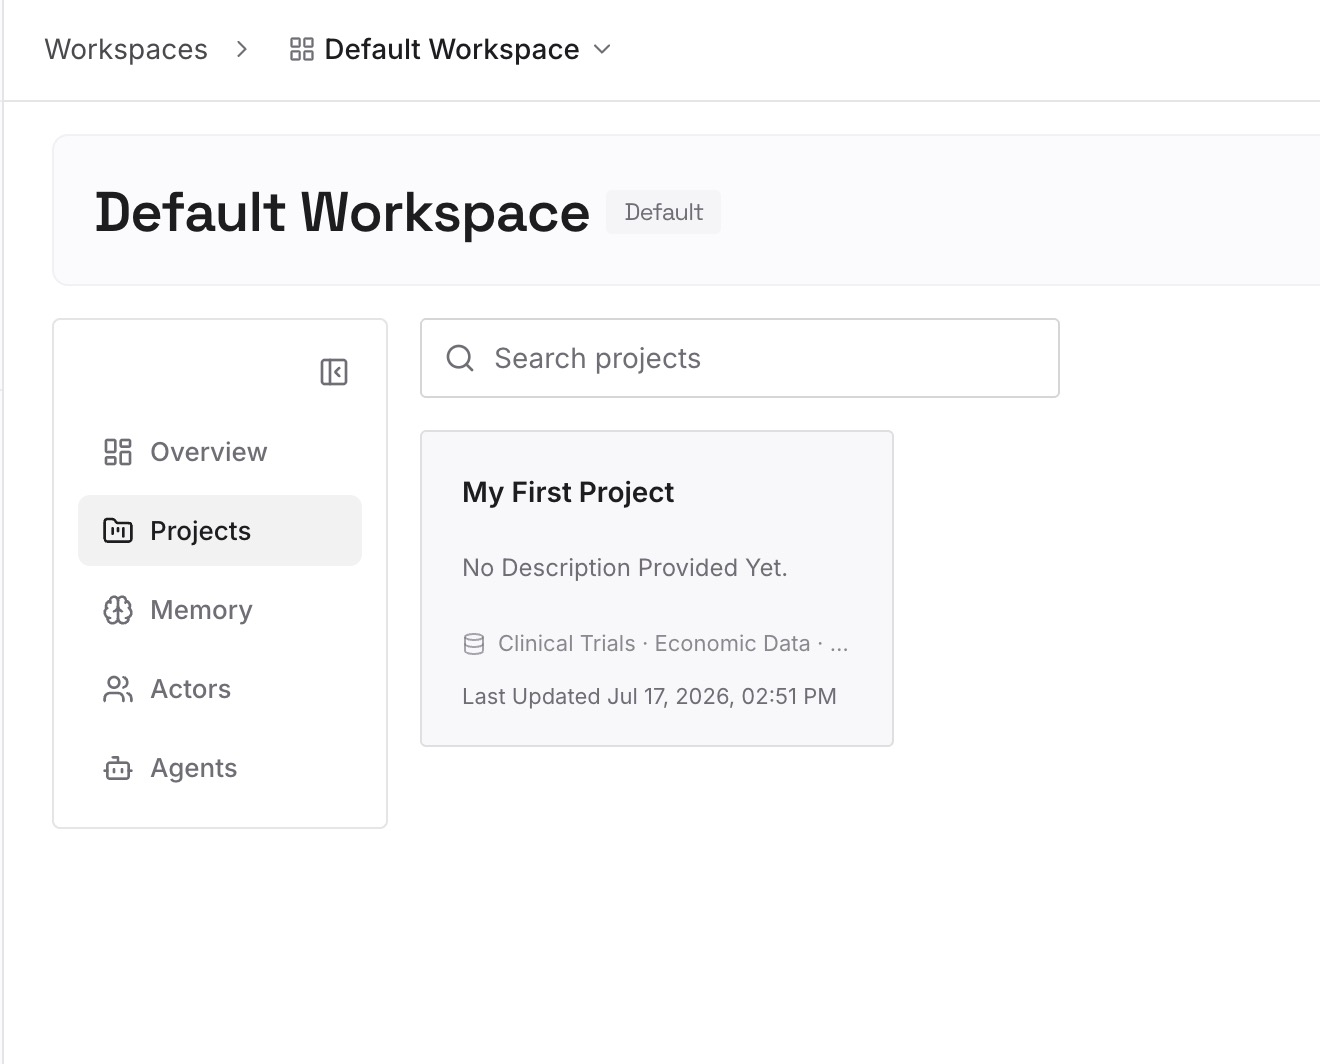
步骤 2:上传您的第一批记忆
将逻辑从您的条目主体和标题中移出:为什么存在每个区间、哪些条目是承重的、您降级了哪些条目以及原因、您历经坎坷才发现的条件。设定集保留设定;这一层保留关于设定的决策。
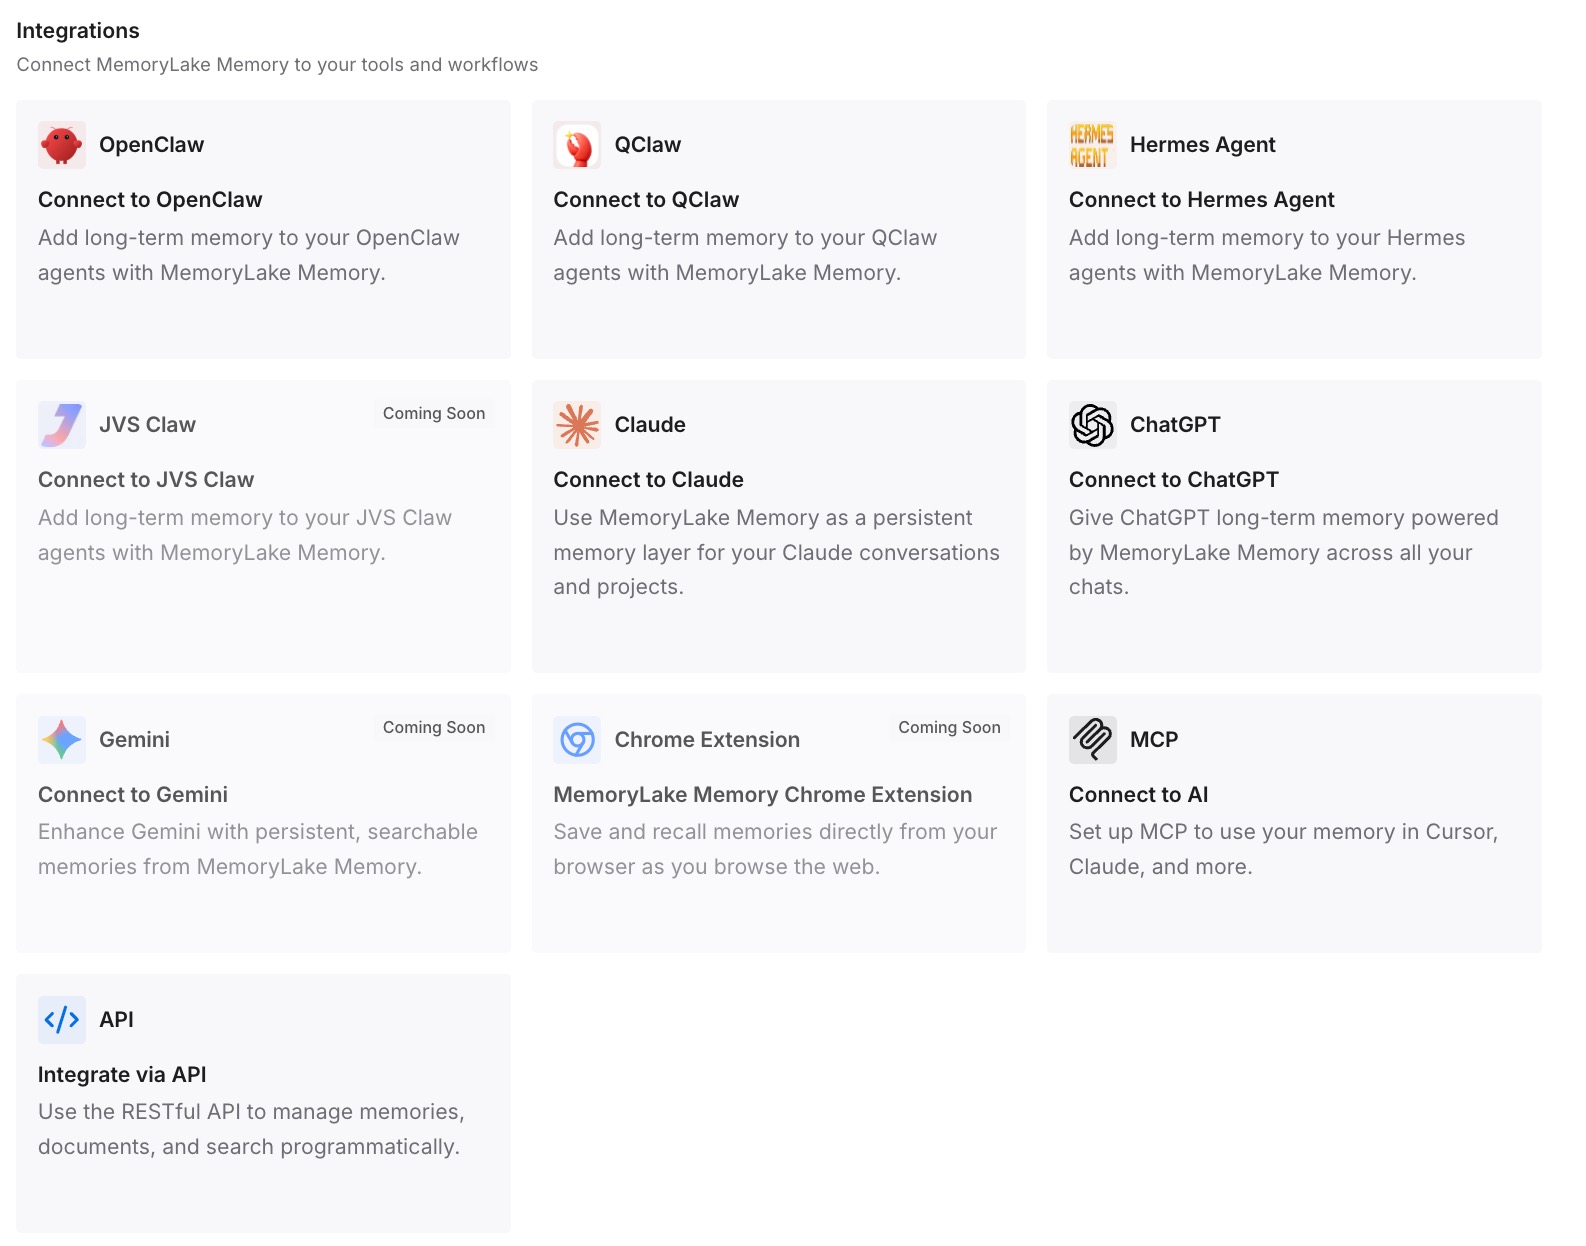
步骤 3:连接您的 AI 和智能体
连接您用来写作的任何工具。相同的决策会送达每一个工具,这很重要,因为设定集不会跟着您去往下一个工具,但背后的思考应该跟过去。
这在实践中带来了什么改变
第一个变化体现在长场景中。一旦高价值条目占据了高数值,预算耗尽时就会从最不重要的那一端开始裁剪,而不是随机裁剪,并且实际送达的条目会落在它们最具影响力的地方。
第二个变化是无声失败变得可以诊断。文档中记录了至少四个导致条目正确却未出现的可能原因——预算耗尽、作者附言被禁用、包含组筛选落选、扫描深度太浅——了解这个列表能将谜团转化为清单。
第三个变化是您的标题不再欺骗您。一旦您接受标题仅供您自己阅读,每个条目都会获得一个独立完整的主体,这正是文档所要求的,即每个条目都应该有一个完整的、独立的描述。
第四个变化是便携性。用文字表达条件的世界在平台迁移中得以幸存;而用插入数字表达的世界则不然。这就是导致迁移痛苦的差距,正如 将 Character AI 设定集迁移到 ChatGPT 中所描述的那样,OpenAI 的文档化个性化界面并没有描述可以接收它们的排序控制项。
世界信息排序的最佳实践
按位置编号,而不是按排名。 越高意味着越靠后,越靠后意味着影响越大。如果需要的话,把这句话写在便利贴上。
留出间距。 以 100 为间隔的区间允许您在不重新为整个世界编号的情况下插入新条目。
刻意规划常驻条目的预算。 它们最先插入,也最先消耗预算。保持蓝圈列表足够短,短到凭记忆就能叫出名字。
将硬性约束放在深度位置,而不是顶部。 深度位置将内容置于靠近生成的位置,而不会使其永久化。
在使用其位置之前,先检查作者附言。 当作者附言被禁用时,分配给作者附言位置的条目将被忽略。
给每个条目一个独立的主体。 标题和关键词不会被插入到上下文中,因此一个只有结合标题才有意义的条目,实际上是一个没有意义的条目。
在任何预算或策略更改后重新测试。 更改设定插入策略会改变您数字对比的基准,而更改预算会改变截断发生的位置。这两者都是无声发生的。
结论
SillyTavern 为您提供了一个真正强大的提示词管理系统,并对其进行了妥善的文档记录,包括那些反直觉的部分。插入顺序不是排名,而是一个位置,较高的数值插入位置更靠后且更重要。同一个数字决定了预算耗尽时谁能存活,也可以被用来决定包含组的胜出者。
按邻近度在宽区间内重新编号,对必须靠后插入的内容使用位置和深度,并通过观察实际送达的内容而不是阅读面板来进行验证。然后将逻辑从条目主体中移出,因为数字字段不适合记录您的世界为何如此运转——而且因为您使用的下一个工具将拥有它自己的控制项、它自己的预算,并且根本无法读取这个设定集。