什么是 Codex subagents
OpenAI 的文档使用了三个术语。subagent 工作流是指 Codex 运行并行智能体并合并其结果的过程。subagent 是 Codex 启动以处理特定任务的委派智能体。智能体线程是 subagent 执行工作的地方,支持的客户端允许你打开它。
它们在哪里运行
Subagents 可以在 ChatGPT 桌面应用、Codex CLI、IDE 扩展以及 ChatGPT Work 中运行。OpenAI 表示:“当前的 Codex 版本默认启用 subagent 工作流。”在 ChatGPT Work 中,智能体在 ChatGPT 的托管环境中运行,聊天界面会显示它们的活动和结果。
它们并不是免费的。OpenAI 指出:“由于每个 subagent 都有自己的模型和工具工作,subagent 工作流比同等的单智能体运行消耗更多的 token。”
它们如何启动
在本地 Codex 中,当你提出要求或指令要求 Codex 进行委派时,subagents 就会启动。OpenAI 表示,当前的本地版本会在“你直接询问或适用的 AGENTS.md 或技能指令要求时”进行委派。在实践中,这意味着诸如“生成两个智能体”、“并行委派此工作”或“每个要点使用一个智能体”之类的提示词。
在 ChatGPT Work 中,你可以在大多数智能级别提出要求。在 Ultra 级别,ChatGPT 可以无需单独请求即可委派合适的工作。
它们为什么存在
OpenAI 给出的理由是关于上下文,而不是速度。如果你在主聊天中填满了探索笔记、测试日志、堆栈跟踪和命令输出,“会话可能会随着时间的推移变得不那么可靠。”OpenAI 提到了两种影响:上下文污染(有用信息被埋没)和上下文腐烂(随着聊天中充斥着不太相关的细节,性能会下降)。
Subagents 将这些噪音移出主线程。OpenAI 的建议是让主智能体“专注于需求、决策和最终输出”,并让 subagents 返回摘要而不是原始的中间输出。
每个 subagent 开始时具备什么
这是 subagents 与你自己打开的第二个聊天窗口最大的不同之处。subagent 会自动从你的会话中获取某些内容,而其他内容只有在被赋予时才能获取。
任务,可能还有对话
每个 subagent 都会得到一个任务。它是否同时获得你的对话内容,是在启动时做出的选择。在 Codex 的开源代码中,启动 subagent 的工具有一个选项,描述为:“True 将当前线程历史记录分叉到新智能体中;false 或省略则仅从初始提示词开始。”
因此,一个 subagent 开始时可能只知道它的任务说明。如果你的主聊天中包含一项决策,例如你选择了哪个库或哪些文件是禁区,不要假设 subagent 知道这一点。请将其放入请求中,或要求 Codex 在委派时包含它。OpenAI 自己的建议也指向了同样的方向:“一个好的 subagent 提示词应该解释如何划分工作,Codex 是否应该等待所有智能体完成后再继续,以及返回什么摘要或输出。”
如果你想要对话的完整副本以探索不同的方向,那是另一个功能。我们的 Codex 聊天分叉指南涵盖了这一点。Claude Code 的 subagents 也提出了关于每个助手知道什么的问题,我们的关于为什么 Claude Code subagents 不共享记忆的指南涵盖了那一方面。
您的模型设置
如果你不进行任何配置,OpenAI 表示“subagent 将继承父智能体的模型和推理努力程度(reasoning effort)”。你可以在提示词中更改此设置,在 config.toml 的 [agents] 下设置默认值,或者在自定义智能体文件中进行设置。OpenAI 建议对狭窄、可重复的工作使用更快的模型,对需要计划和验证的智能体使用更强大的模型。
您的沙箱和审批
Subagents 继承你当前的沙箱策略。在桌面应用和 IDE 扩展中,它们继承编辑器下方选择的权限模式,因此在要求 Codex 委派之前请先选择好。在 CLI 中,OpenAI 表示:“Subagents 继承父轮次的当前沙箱和审批设置,包括使用 /permissions 或 --yolo 所做的更改。”
自定义智能体无法放宽这一点。OpenAI 明确表示:“自定义智能体指令可以要求智能体避免编辑,但它们不会创建一个单独的只读沙箱。”
您的技能、MCP 服务器和记忆
自定义智能体“继承父级的权限、提供商和 MCP 服务器;自定义智能体文件无法覆盖这些设置。”技能也继承自父级,自定义智能体可以使用 skills.config 关闭单个技能。
记忆(Memories)是自定义智能体可以关闭的功能之一。OpenAI 将 features.memories 列在你可以设置为 false 以减少智能体功能的特征键中。如果你开启了 Codex 的本地记忆,我们的 Codex 本地记忆指南解释了它们保存的内容以及如何控制它们。
什么内容会返回到您的主聊天
主线程获得的是结果,而不是完整的工作过程。当多个智能体运行时,OpenAI 表示:“Codex 会等待所有请求的结果都可用,然后返回一个合并的响应。”
工作本身保留在每个智能体线程中。在桌面应用中,OpenAI 表示它会“显示每个 subagent 线程,以便你可以检查其工作以及返回给主聊天的摘要”。在 CLI 中,/subagents 允许你在运行期间切换智能体线程。在 ChatGPT Work 中,Subagents 面板显示只读的“活动中”和“已完成”列表,你可以打开一个已完成的 subagent 来查看其详细信息和结果。
这种设计保持了主聊天的整洁。这也意味着发现背后的推理(例如 subagent 阅读了哪些文件或排除了哪种方法)存在于你必须打开的线程中。如果以后很重要,则需要将其记录在线程之外的某个地方。
内置和自定义智能体
Codex 附带三个内置智能体:
default:通用备用智能体worker:用于实现和修复explorer:用于读取密集的代码库探索
你可以将自己的智能体定义为 TOML 文件,每个智能体一个文件,个人智能体放在 ~/.codex/agents/ 中,项目范围的智能体放在 .codex/agents/ 中。每个文件必须定义 name、description 和 developer_instructions。OpenAI 的文档包含了这个审查者示例,保存为 .codex/agents/reviewer.toml:
name = "reviewer"
description = "专注于正确性、安全性和缺失测试的 PR 审查者。"
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
developer_instructions = """
像所有者一样审查代码。
不要编辑文件。
优先考虑正确性、安全性、行为回归和缺失的测试覆盖率。
以具体的发现为先导,尽可能包含复现步骤,除非隐藏了真正的错误,否则避免仅针对风格的评论。
"""
OpenAI 对自定义智能体的建议是保持它们的专注:“最好的自定义智能体是狭窄且有主见的。”如果自定义智能体的名称与内置智能体(如 explorer)匹配,则你的智能体优先。
全局设置
适用于所有 subagents 的设置位于配置中的 [agents] 下。agents.enabled 默认为 true;将其设置为 false 可关闭多智能体工具。agents.max_concurrent_threads_per_session 限制了除主线程外可以同时打开的生成智能体线程数,agents.max_threads 仍作为旧别名起作用。agents.default_subagent_model 和 agents.default_subagent_reasoning_effort 设置了显式请求可以覆盖的默认值。
在运行期间引导 subagents
你不需要等待。在桌面应用、CLI 和 IDE 扩展中,你可以要求 Codex 引导正在运行的 subagent、停止它或关闭已完成的线程。在 CLI 中,审批请求可能来自你未查看的智能体线程;叠加层会显示哪个线程正在请求,你可以在回答之前按 o 打开它。
OpenAI 还对一种工作提出了警告。并行智能体适用于读取密集型任务,如探索、测试、分类和总结。它表示:“对于并行的写入密集型工作流要更加小心,因为同时编辑代码的智能体可能会产生冲突并增加协调开销。”
人们首先尝试的事情
假设 subagent 知道整个对话。 它可能只从其任务开始。请在请求中放入关键决策。
使用自定义智能体文件使智能体变为只读。 指令可以要求它不编辑,但沙箱仍然来自父会话。
在自定义智能体文件中设置 MCP 服务器。 它们不会覆盖父级。请在父会话中配置 MCP 服务器。
运行多个编辑相同代码的智能体。 OpenAI 建议对并行写入保持谨慎。主要将并行智能体用于读取和检查。
运行结束后丢失发现。 主聊天得到的是摘要。如果某个细节很重要,请在继续之前将其保存。
解决方案:简报每个 subagent,保留主聊天用于决策,并记录你学到的内容
第 1 步:编写简报,而不仅仅是任务
当你要求 Codex 委派时,说明如何拆分工作、每个智能体应该返回什么以及是否等待所有智能体。包含每个智能体需要的决策:约束条件、不要动的文件、已经排除的方法。持久的规则属于 AGENTS.md,Codex 每次都可以遵循它们;我们的关于 Codex 跳过 AGENTS.md 规则的指南涵盖了 Codex 如何找到这些文件。
第 2 步:在委派之前设置权限和智能体
首先为父轮次选择权限模式,因为 subagents 会继承它。对于重复的工作,创建具有狭窄指令和适合该工作的模型的自定义智能体,并关闭该工作不需要的功能。
第 3 步:保存 subagents 的发现
当合并后的答案到达时,打开重要的智能体线程并提取值得保留的发现:风险、决策、死胡同。将它们写在下一次会话可以看到的地方。对于具有明确终点的长任务,我们的 Codex Goal 模式指南解释了如何让主聊天始终指向结果。
在 MemoryLake 中设置
Subagents 产生发现;保留它们取决于你。每个发现都存在于一个智能体线程中,除非有人将其记录下来,否则下一个任务、聊天或工具启动时将不具备这些发现。
MemoryLake 是一个记忆层,用于将这些发现保存在你维护的一个列表中,供 Codex 和你连接的其他助手(如 ChatGPT 和 Claude Code)使用。
你自己用自己的话编写条目。不会从你的 subagent 线程、你的 AGENTS.md 文件、你的 Codex 记忆或任何供应商的存储中读取、写入或删除任何内容。Subagents 继续按照 OpenAI 描述的方式工作。
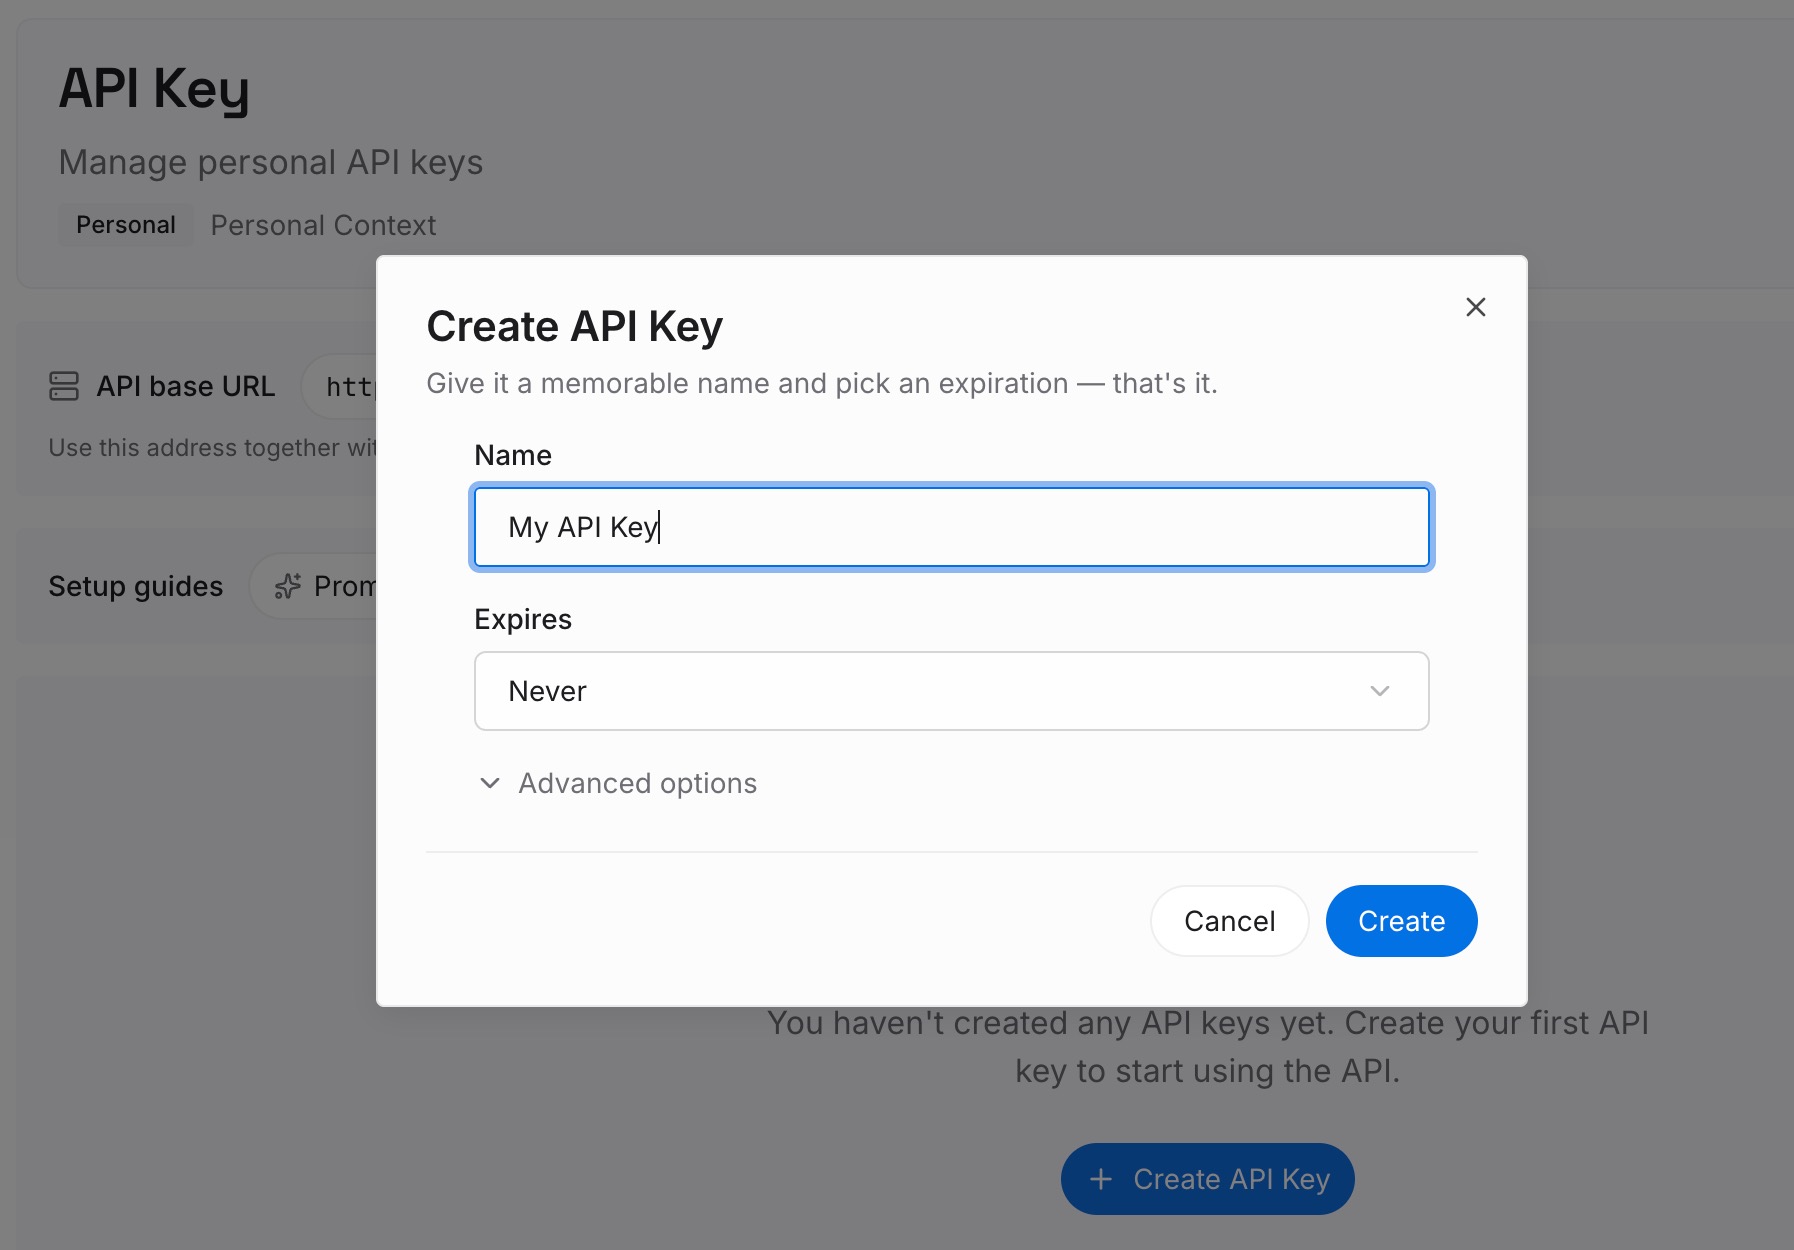
第 1 步:创建 API 密钥
登录并从控制面板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的 ChatGPT 账户和 Codex 配置是分开的。
第 2 步:上传你的第一条记忆
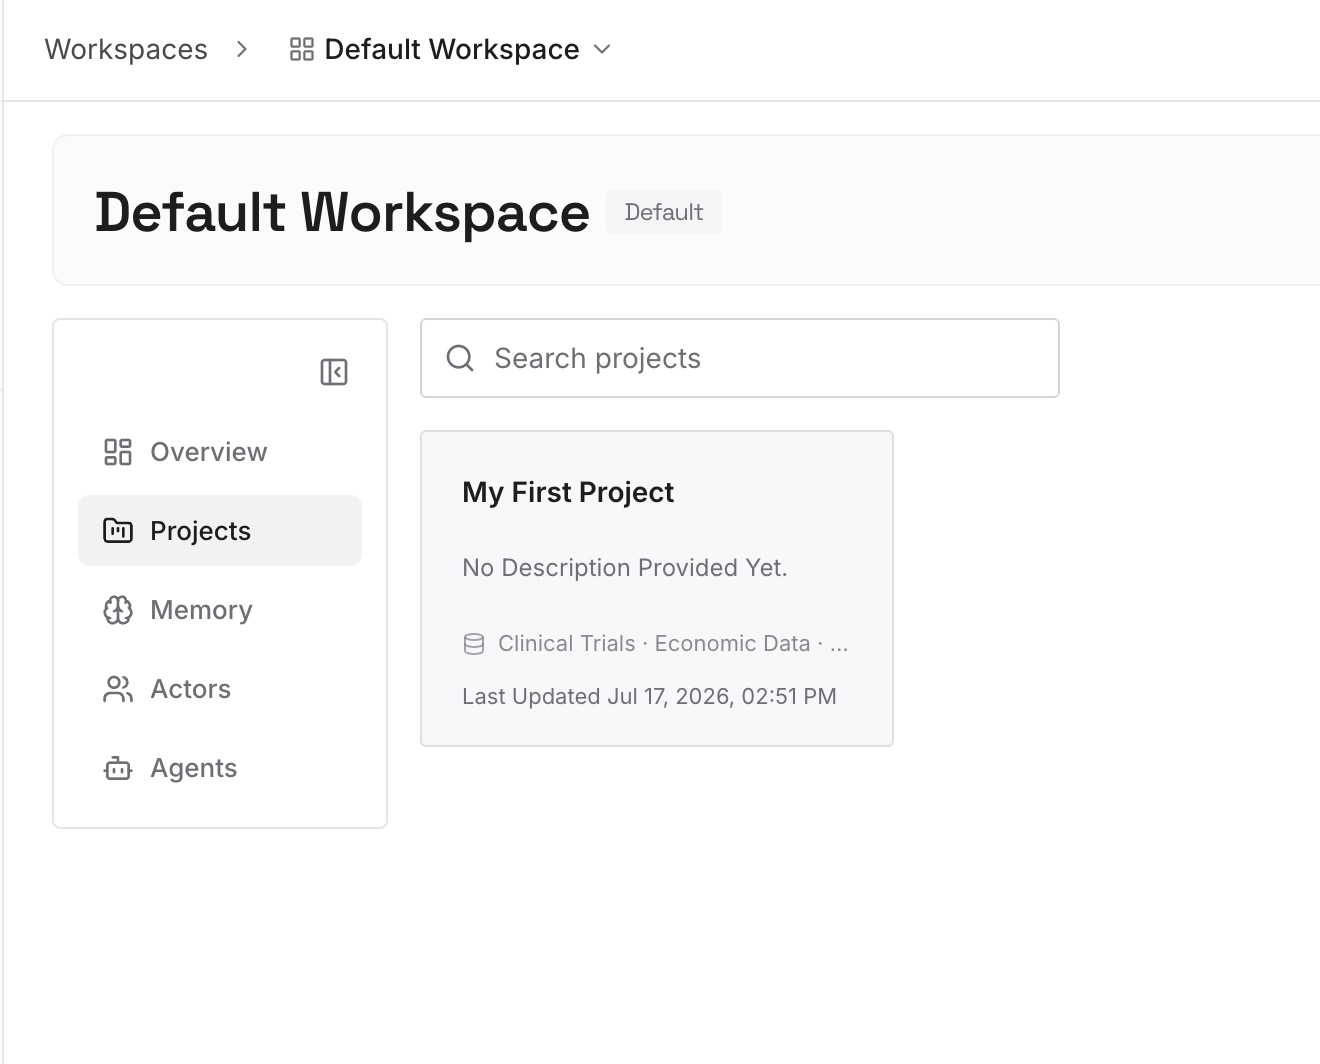
从你在解决方案第 3 步中提取的内容开始:上次 subagent 运行的发现、决策和排除的方法。每个条目一个要点,注明日期,并贴上存储库标签。
第 3 步:连接您的 AI 和智能体
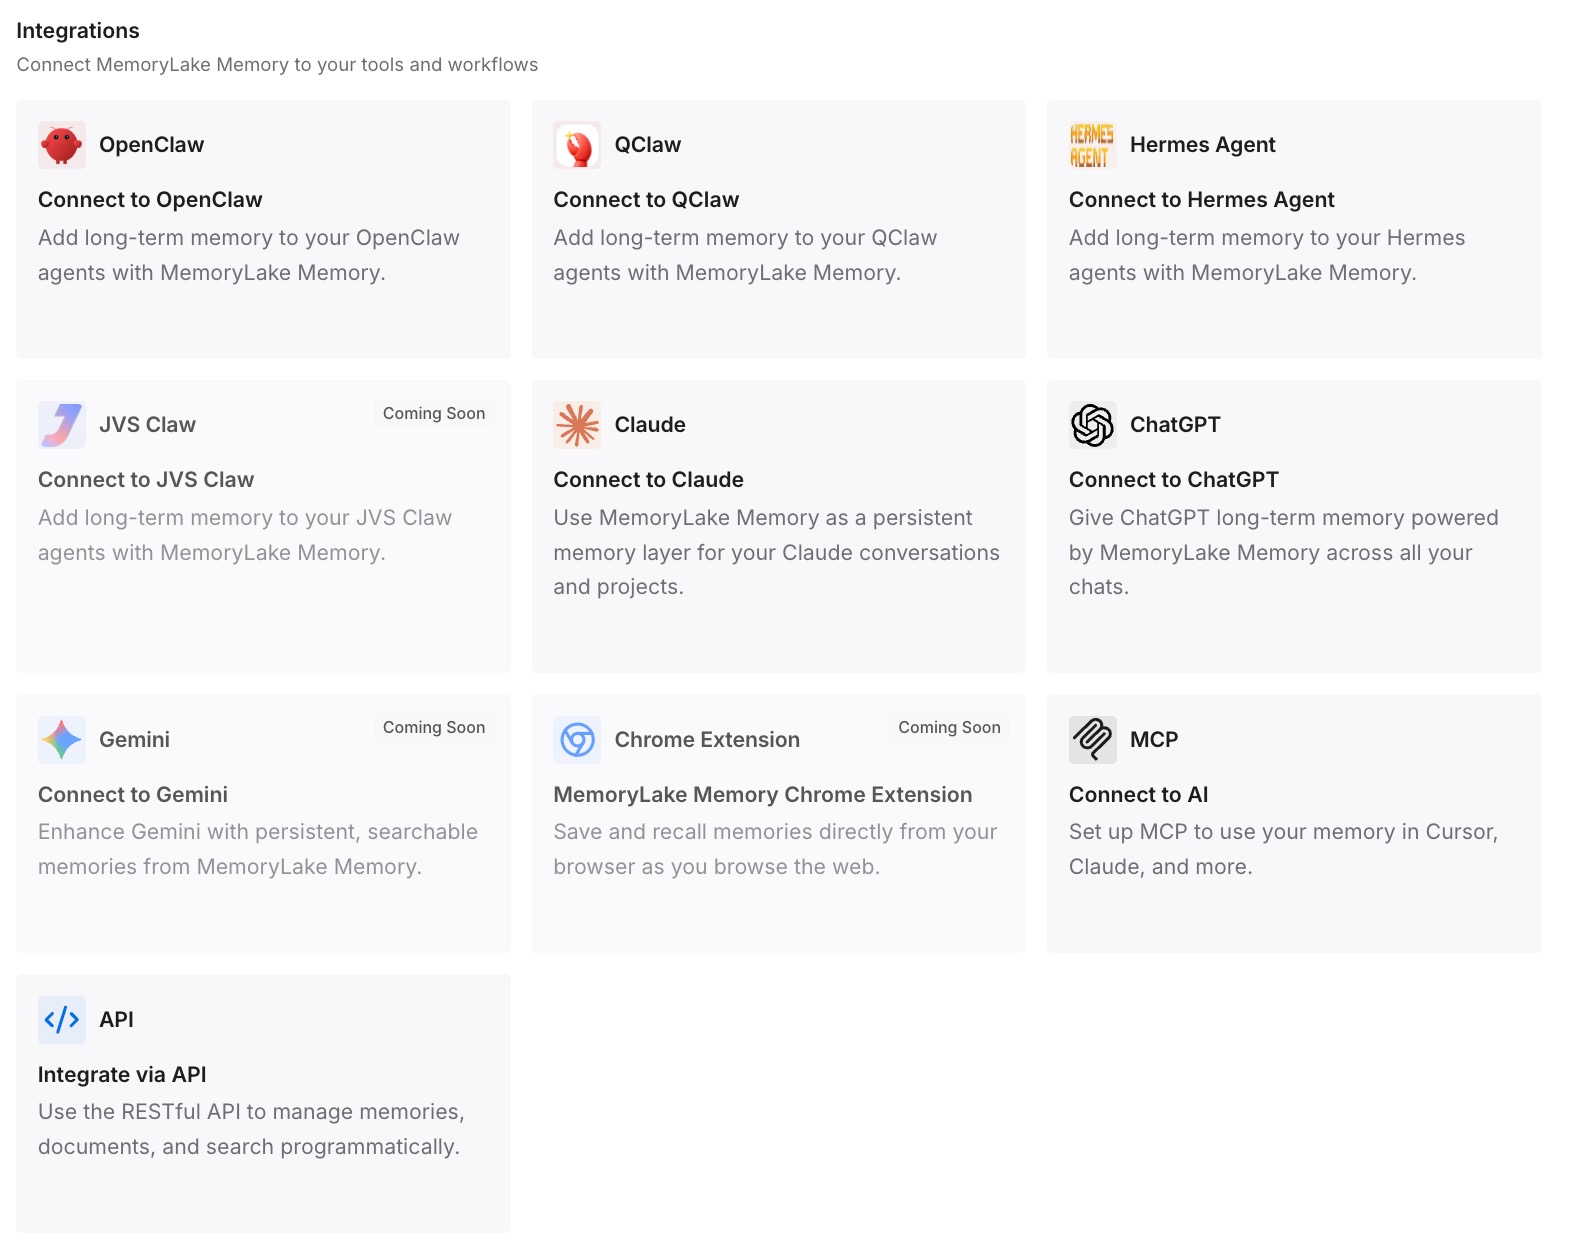
连接 Codex 和你使用的其他助手。下一次简报可以从上一次运行确定的内容开始。
这在实践中改变了什么
第一个区别是 subagents 在开始时就获得了信息。简报携带了它们需要的决策,而不是寄希望于它们继承了这些决策。
第二个区别是主聊天保持专注。嘈杂的工作发生在智能体线程中,主线程保留需求、决策和结果。
第三个区别是发现的寿命超过了运行周期。subagent 学到的内容被记录下来,而不是留在你永远不会重新打开的线程中。如果你担心长会话,我们的关于 Codex 中 GPT-6.1 Sol 默认 500k 上下文的指南涵盖了何时触发压缩。
Codex subagents 的最佳实践
明确要求。 说明如何拆分工作以及返回什么。
在简报中放入决策。 subagent 开始时可能只有其任务。
在委派前设置权限。 Subagents 从父轮次继承权限。
优先选择并行读取而非并行写入。 将 subagents 用于探索、测试、分类和审查。
保持自定义智能体专注。 一项工作,清晰的指令,合适的模型。
在父级中配置 MCP 服务器。 自定义智能体文件无法覆盖它们。
保存发现。 打开重要的线程并记录它们学到的内容。
结论
Codex subagents 是并行运行的委派智能体,每个都在自己的线程中运行,并将结果作为合并响应返回到你的主聊天。它们在当前的 Codex 版本和 ChatGPT Work 中默认开启。每个子智能体都会继承你的模型设置、沙箱和审批、MCP 服务器以及技能,并且除非你的对话被分叉到其中,否则可能仅从其任务开始。
给每个 subagent 一个真正的简报,先设置权限,保持并行工作主要是只读的,并在线程滚出视线之前记录下 subagents 的发现。