为什么新对话开始时没有你的上下文
对话的上下文包含其中的一切:你的消息、回复、文件、工具运行结果。当你开始一个新对话时,这些工作上下文不会随你而去。新对话能找回什么取决于助手在对话之外提供的功能,例如记忆(memory)、对话搜索、项目文件或指令文件。
这些功能有所帮助,但它们在设计上是有选择性的。OpenAI 的记忆文章指出:“记忆不会保留每次对话的每个细节。ChatGPT 会决定哪些可用信息与回复相关,且记忆会随着上下文的变化而改变。”Claude 的对话搜索则会在你要求时,从过去的对话中汇总相关的上下文。
因此,对于继续工作最重要的细节——当前状态、进行了一半的步骤、一小时前排除的选项——你不希望将其留给运气。这就是交接提示词所承载的内容。
各助手能自行恢复的内容
在编写交接内容之前,了解新对话已经能找到什么会很有帮助。
Claude
在付费计划中,Claude 可以搜索早期的对话。Anthropic 的帮助中心表示:“你可以提示 Claude 搜索之前的对话,以便在不同会话之间查找相关信息,并在需要时引用特定细节。”其官方示例提示词包括要求 Claude 从你上次离开的项目处继续。范围是有限的:项目之外的对话会一起搜索,而项目内的搜索则保留在该项目内。
Claude 的记忆也可以将早期对话的上下文带入新对话,且项目文件和指令对该项目中的每个对话都可用。Anthropic 的使用文章建议在某些情况下开启新对话:“如果你在较长的对话中接近使用限制,请尝试开始新对话。”
Claude Code
Claude Code 将会话保存在你的本地机器上,并可以通过 claude --continue、claude --resume 或 /resume 恢复。它还会在每次会话开始时加载 CLAUDE.md 文件,其自动记忆会记录 Claude 根据你的纠正和偏好为自己编写的笔记。
当你在休息后恢复一段长对话时,Claude Code 可能会询问是恢复还是重新开始。其会话文档描述了重新开始选项:“如果选项显示 Claude 可以查找此对话,你仍然可以在新对话中引用早期的工作。”我们关于 Claude Code 恢复警告的指南涵盖了每种选择的适用场景。
ChatGPT
开启“引用聊天记录”后,ChatGPT 可以使用过去对话中的相关信息。OpenAI 指出:“对于 ChatGPT 通过聊天记录引用的内容,没有单独的存储限制。”项目功能增加了在项目内跨对话共享的文件和指令。为了在同一对话中尝试不同的方向,ChatGPT 还可以分支对话,我们关于分支 ChatGPT 对话的指南涵盖了这一点。
Codex
Codex 可以通过 /resume 恢复保存的会话,其文档将其描述为“从之前的 CLI 会话继续工作而无需重新开始”的一种方式。/compact 会总结可见的对话以释放 token。Codex 还会读取 AGENTS.md 文件,其本地记忆(开启时)会在同一台机器的对话之间传递上下文。OpenAI 的记忆页面增加了一个值得记住的提醒:“将记忆视为一个有用的召回层,而不是必须始终适用的规则的唯一来源。”
四者共同的空白
每个助手都能找回部分过去。但这些功能都不是为了告诉下一个对话工作具体进展到哪里、哪些决策是最终的、以及哪些不应再次尝试。这正是交接提示词的工作。
优秀的交接提示词包含什么
交接提示词应简短、具体,并为一位一无所知的读者编写。以下是发挥作用的部分:
- 目标。用一两句话说明工作的目的以及完成的标准。
- 当前状态。已完成的内容、进行中的内容,以及进行中部分停在哪里。
- 决策及其原因。已确定的事项及其原因,以免新对话重新讨论。
- 约束条件。适用于后续所有内容的的要求、偏好和限制。
- 已排除的内容。你尝试过或拒绝过的方法,并简要说明原因。
- 待办问题。仍需解答的问题。
- 下一步计划。新对话首先应该做的一件事。
- 材料。新对话需要哪些文件、链接或文档,以及哪些不需要。
除了决策之外,省去你如何到达那里的历史。省去客套话。一份好的交接内容应能在一屏内显示。
人们首先尝试的做法
粘贴整个旧对话。这会带来所有内容,包括噪音,在 Claude 中,它会将同样的长度问题带入新对话。
重新开始并希望记忆能填补空白。记忆和搜索有所帮助,但它们无法可靠地带回工作的当前状态。
凭记忆编写总结。你会记住目标,但会忘记两小时前做出的决策。
要求无结构的总结。你会得到对话的回顾,而不是下一个对话可以执行的简报。
解决方案:要求旧对话生成结构化交接,检查它,然后用它开启新对话
第 1 步:在离开前要求旧对话编写交接内容
旧对话拥有上下文,因此它应该编写初稿。要求结构化内容,而不是回顾。像这样的提示词适用于 Claude、ChatGPT、Claude Code 和 Codex:
请为新对话编写一份交接内容,新对话将继续这项工作,但没有任何此对话的记录。
使用这些标题:目标、当前状态、决策(及每项的原因)、约束条件、已排除(及原因)、待办问题、下一步计划、所需材料。
请具体化:名称、数字、文件路径、关键处的准确措辞。
保持在一页以内。除了决策,不要包含我们如何到达这里的历史。
在 Claude Code 或 Codex 中,增加一行要求它包含它更改的文件以及检查工作所需的命令。
第 2 步:阅读并修正错误
初稿会很不错但并不完美。检查三件事:当前状态是否符合你的认知;你关心的每个决策及其原因是否都在其中;下一步计划是否是你选择的那个。添加任何遗漏的内容。如果初稿中的决策有误,请在此处纠正,而不是在新对话中纠正。
将最终版本保存在你控制的地方,而不仅仅是在旧对话中。
第 3 步:用交接内容开启新对话,然后确认
将交接内容作为第一条消息粘贴,并仅附加它列出的材料。然后要求新对话在执行任何操作之前,用它自己的话复述目标、当前状态和下一步计划。如果它的复述有偏差,交接内容就需要再加一行。
在 Claude Code 中,将适用于每个会话的部分(如项目规范)放入 CLAUDE.md,而不是在每次交接中重复。在 Codex 中,AGENTS.md 也是如此。在 Claude 或 ChatGPT 中,适用于项目中跨对话的规则属于该项目的指令。
在 MemoryLake 中设置
交接提示词将一项工作从一个对话带到下一个对话。几周后,这些交接中的决策和约束开始重复:相同的规范、相同的偏好、相同的已定问题。它们是你希望每个新对话在开始时就拥有的上下文,无论你使用哪个助手。
MemoryLake 是一个记忆层,用于将这些循环出现的上下文保存在你维护的一个列表中,供 ChatGPT 以及你连接的其他助手(如 Claude Code 和 Codex)使用。
你用自己的话编写条目。不会从你的对话、助手记忆、项目文件、会话历史或任何供应商的存储中读取、写入或删除任何内容。对于工作内容,请遵循你组织关于在工具之外保留内容的政策。
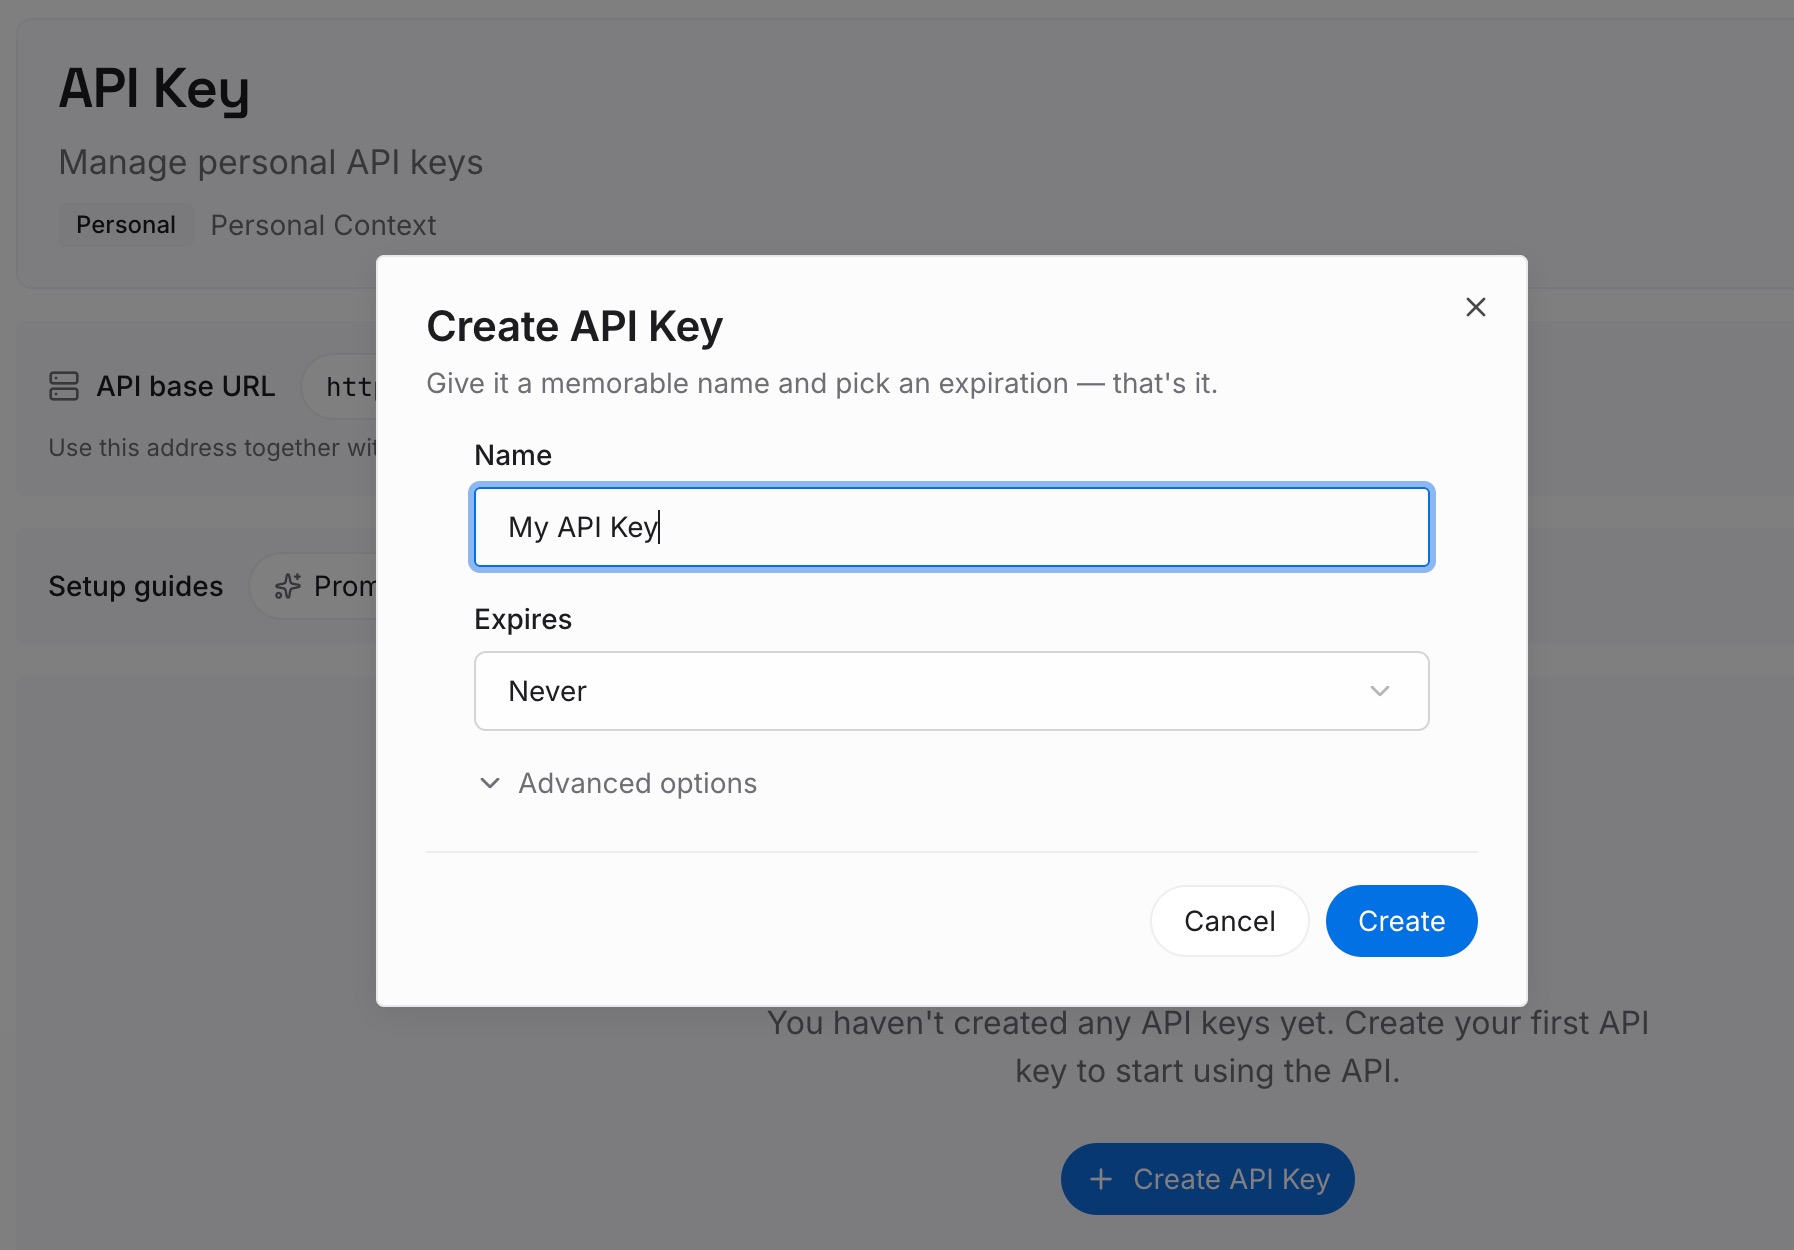
第 1 步:创建 API 密钥
登录并从控制面板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的助手账户分开。
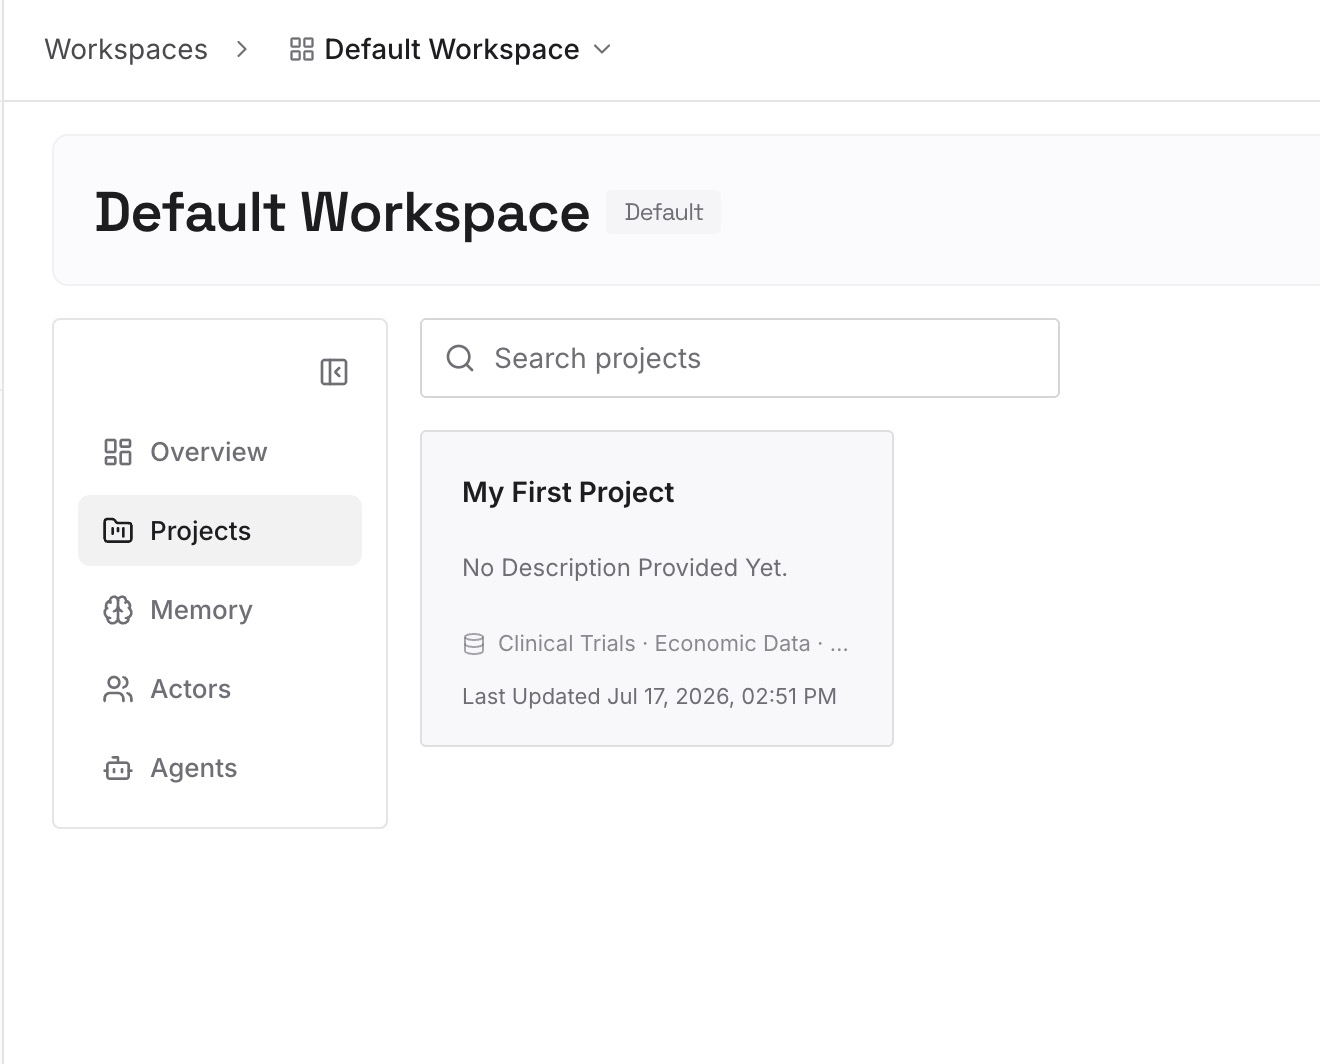
第 2 步:上传你的第一批记忆
从你最近交接内容的“决策”和“约束条件”部分开始,这些部分也适用于下一项工作。每个条目一个要点,注明日期,并贴上所属项目的标签。
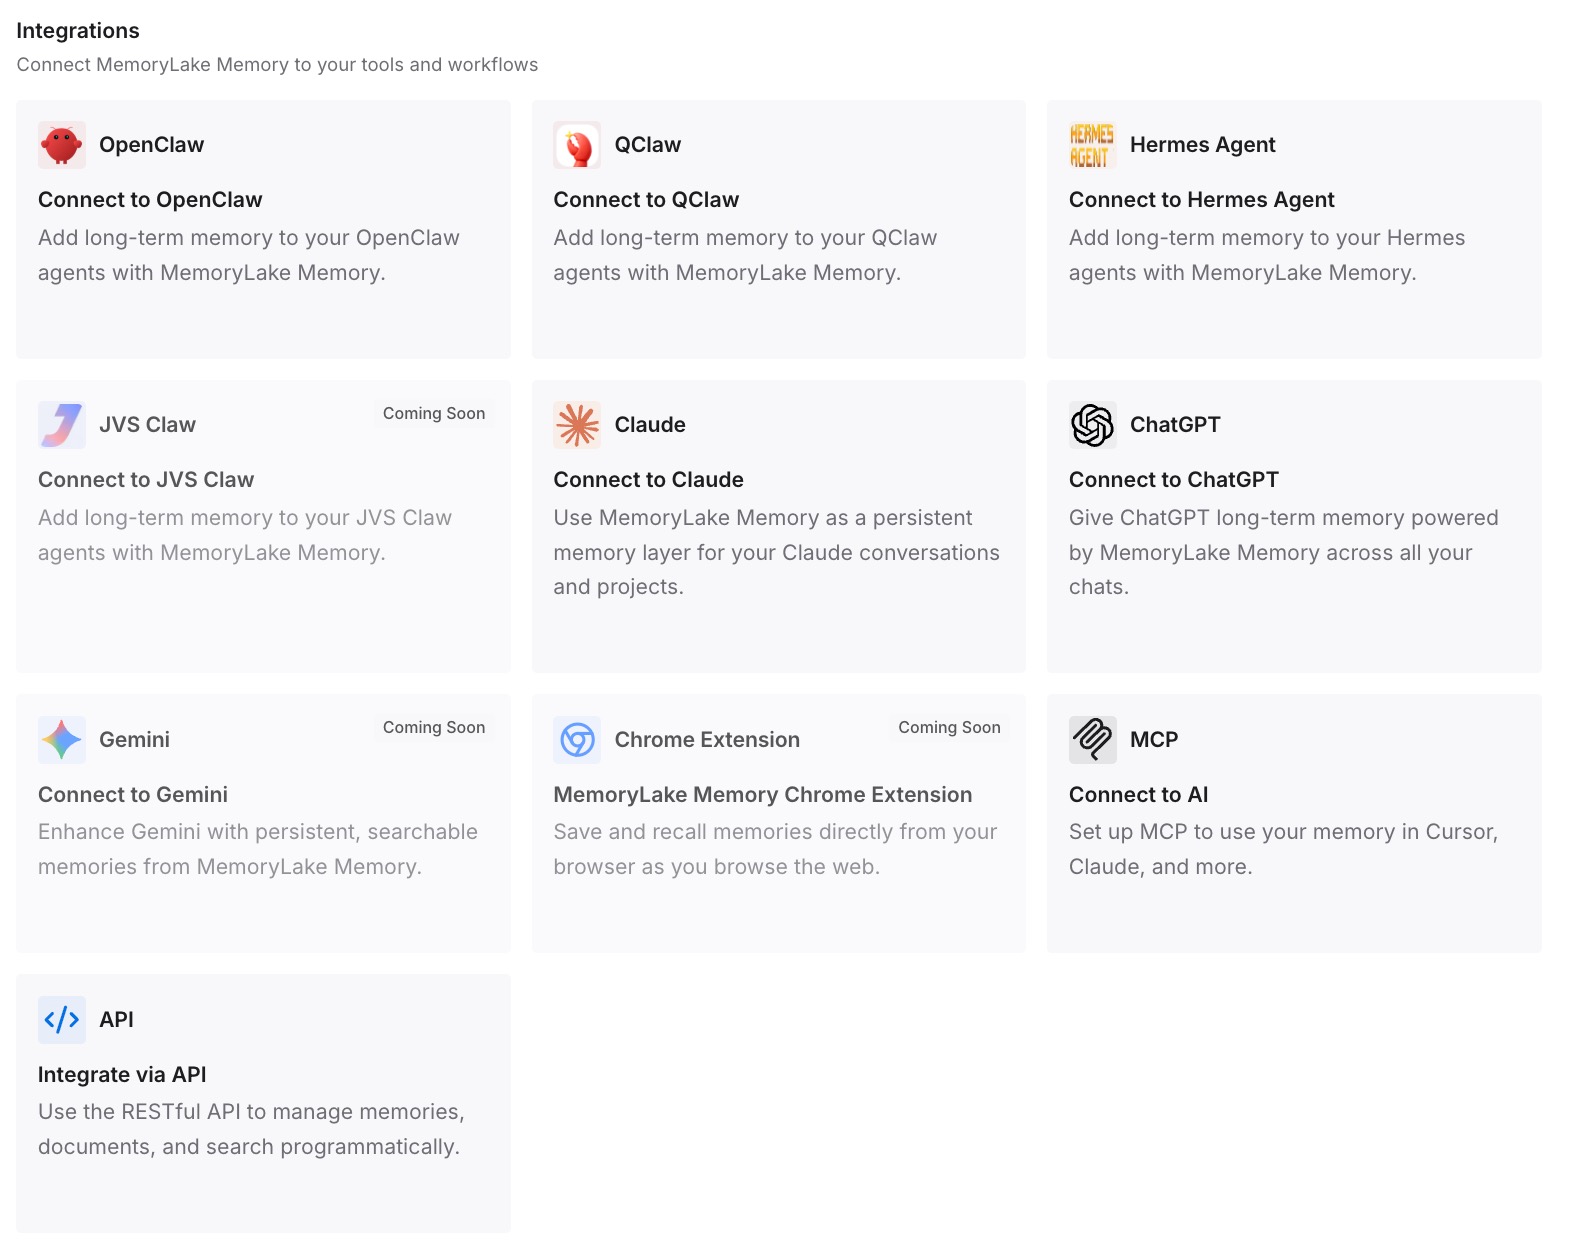
第 3 步:连接你的 AI 和代理
连接 ChatGPT 和你使用的其他助手。你的下一次交接可以更短,因为常驻上下文已经存在了。
这在实践中改变了什么
第一个区别是离开对话不再让你损失工作进度。新对话在第一条消息中就以目标、状态和下一步计划开始。
第二个区别是决策保持不变。原因随之传递,因此新对话不会通过争论回到你已经拒绝的选项。
第三个区别是你可以像在对话之间切换一样轻松地在助手之间切换。在 Claude 中编写的交接内容在 ChatGPT、Claude Code 或 Codex 中同样有效。如果你是将对话交给另一个人而不是新对话,我们关于共享 Claude 对话及其遗漏上下文的指南涵盖了这种情况。
交接提示词的最佳实践
要求旧对话编写它。它拥有你会忘记的上下文。
使用固定标题。结构化是使其可用的关键。
包含每个决策的原因。没有原因的决策会被重新讨论。
列出已排除的内容。这能避免新对话重复死胡同。
保持在一屏以内。过长的交接内容会带回你想要摆脱的问题。
粘贴前进行检查。亲自纠正状态和决策。
将常驻规则移入指令文件。如 CLAUDE.md、AGENTS.md 或项目指令,以便交接内容保持简短。
要求新对话复述计划。这是测试交接是否成功最快的方法。
为了记录 Codex 会话并进行交接,我们关于导出 Codex 对话的指南涵盖了保存完整对话的方法。
结论
新对话开始时没有旧对话的工作上下文。记忆、对话搜索、恢复和指令文件可以找回一部分,但无法可靠地找回当前状态、已定决策和下一步计划。
交接提示词填补了这一空白。要求旧对话在固定标题下编写它,检查并纠正它,然后用它开启新对话。将适用于每个会话的规则放入助手的指令文件中,并将循环出现的决策保存在你控制的地方。如果 Claude 本身似乎丢失了早期对话的记录,我们关于让 Claude 记住以前对话的指南涵盖了控制它的设置。